GLOBAL GEOCHEMICAL ATLAS SKILL · global-geochemical-atlas 决赛 08 · 气候与地球科学赛道 · 词元代理人队
AI4S FUTURE SCIENCESKILLS HACKATHON · 气候与地球科学赛道
全球地球化学元素
面向 AI Agent 的可复用科研 Skill
一句话让 AI 为我生成全球元素地图,AI Agent 全自动可信科研图谱 。
github.com/asimfish/global-geochemical-atlas-skill
live/world-atlas.html · 自包含单文件 · 即点即用 LIVE
多源采集 36 SOURCES →
标准化 mg/kg · WGS84 →
质控修复 ITERATION LOOP →
异常识别 ROBUST-Z · FDR →
时序归因 GEOGENIC / INPUT →
成稿论文 5 个科学问题
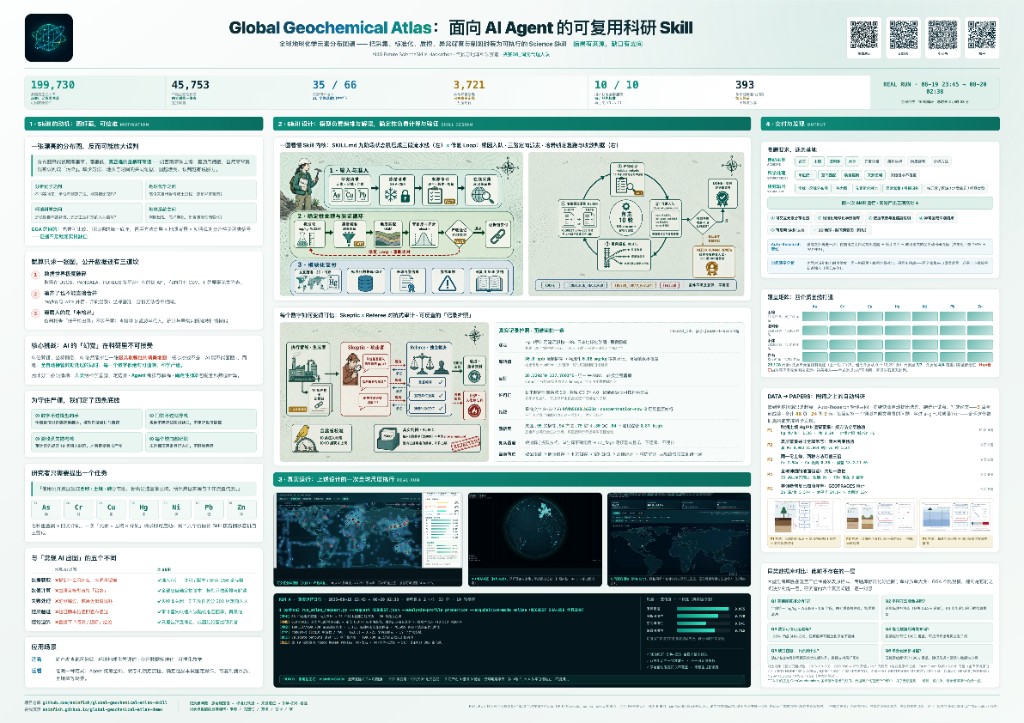
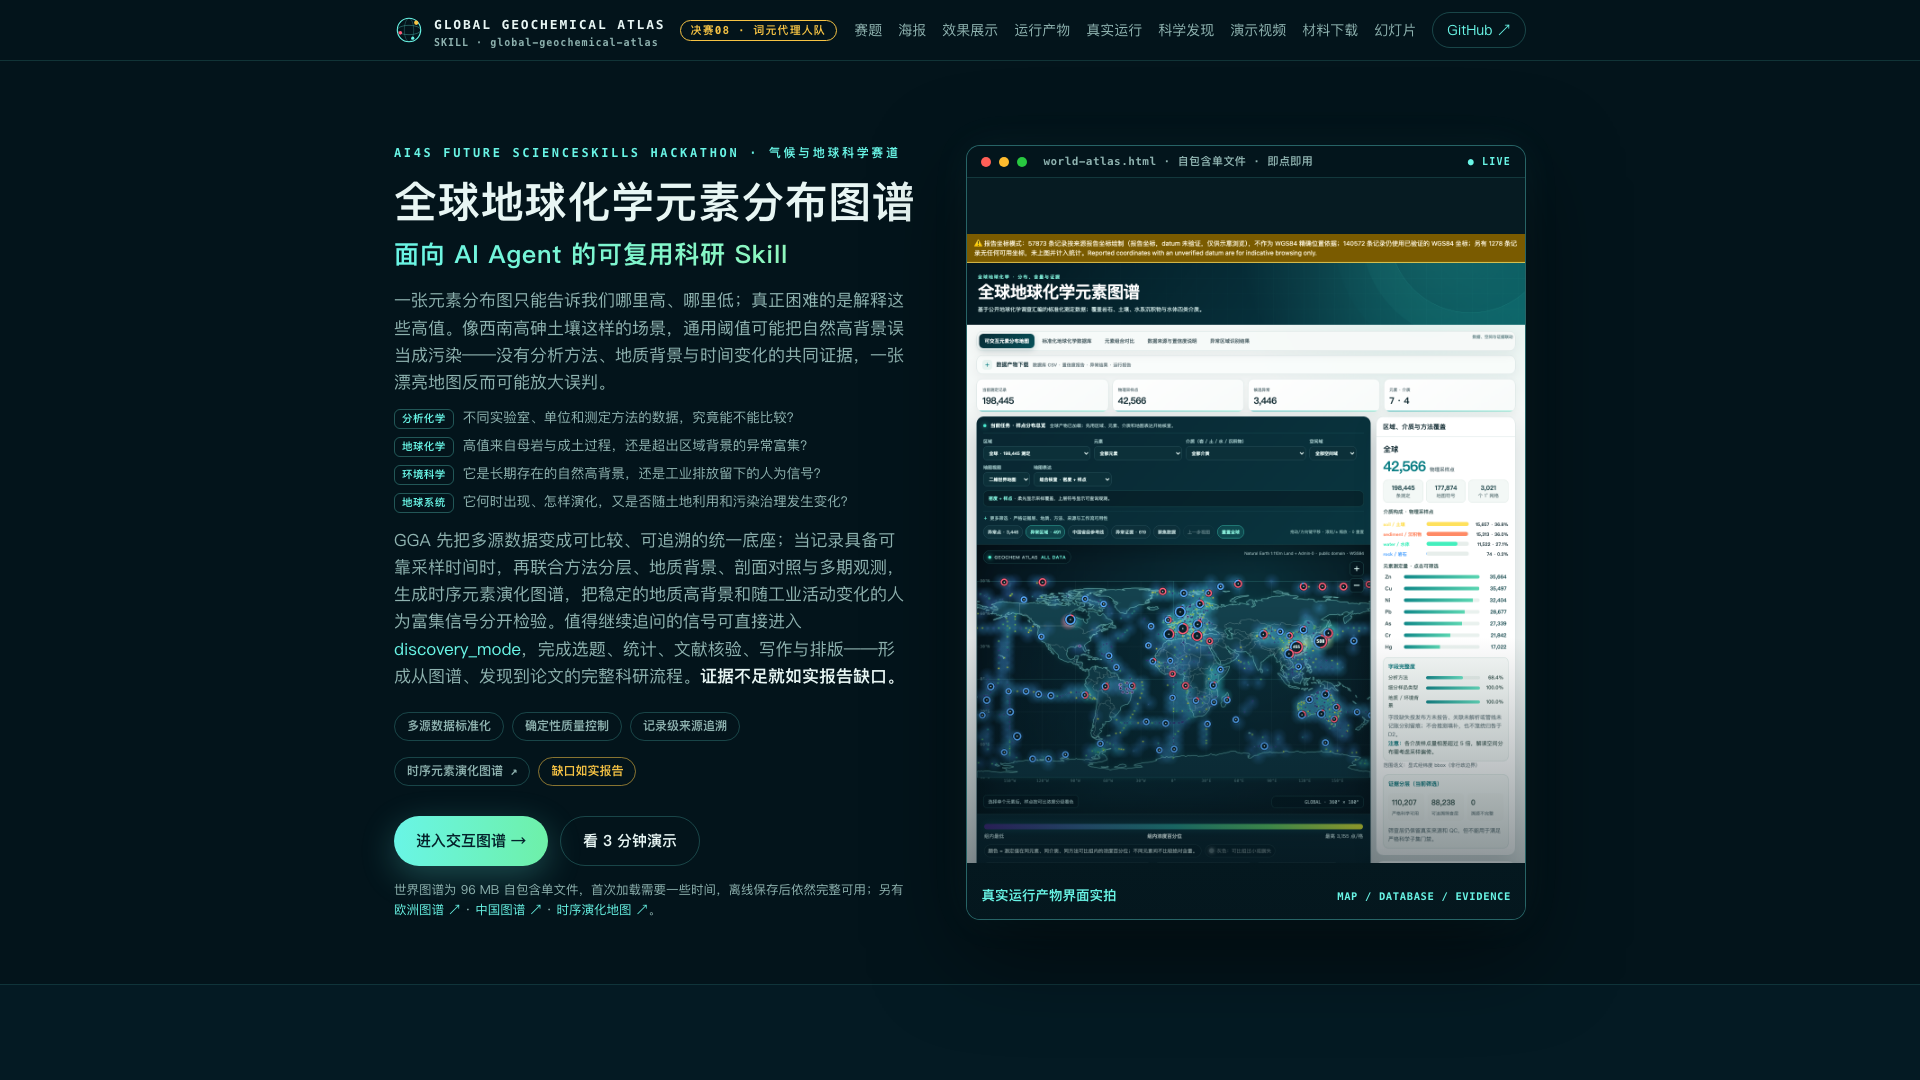
各位评委好,我们是词元代理人队。我们做的是全球地球化学元素分布图谱——一个面向 AI Agent 的可复用科研 Skill。Agent 接到元素、区域、地质单元和样品类型请求后,能够采集公开测定、完成科学标准化、生成研究视图,并把每个关键结论绑定到记录级证据。地图只是入口;真正的产品是可追溯、可验证、可迭代、可跨 Agent 平台复用的 Skill。
证据
00 · CONTENTS
目录
01 研究问题 一句提问,四个角色的证据难题
01–02 04 效果与创新点 四域图谱 · 时序演化 · 五篇论文 · 作品展示
13–18
一句话,让 Agent 帮我生成可信、可回溯、可交互 的时序演进
研究问题 → 输出产物 → Skill 机制 → 效果与创新点 → 团队介绍
这页是目录。整场演示围绕一句话展开:让 Agent 帮我生成可信、可回溯、可交互的时序演进全球化学元素分布图谱。五个章节:研究问题——一句提问背后四个角色的证据难题;输出产物——五项赛题交付逐项实测;Skill 机制——模型提案、代码裁决;效果与创新点——四个分析域的图谱、时序演化和五篇论文;最后是团队介绍。
01 · WHY THIS SKILL / FROM A QUESTION TO AN EVIDENCE CHAIN
一句听起来很简单的提问
一位地球化学研究者的提问 “ 帮我画一张全球土壤砷元素的分布图谱,”
这听起来像一个检索问题。但放进真实的研究团队,它马上变成四个更难的问题:
🧪 地球化学家 几十个调查、三种单位、五种消解方法——这些数字能放进同一张图里比吗?
→ 统一指标 🏛️ 环境监管 西南的砷比全国中位数高好几倍,是污染超标,还是地质本底就这么高?
→ 动态时序 🗂️ 数据管理员 这条 1978 年的老记录,检出限、坐标系、许可证,现在还查得到吗?
→ 质量控制 ⚖️ 评审专家 AI 给出的每一个数字,出处在哪一页哪一行?敢直接引用吗?
→ 来源可回溯
四个问题,指向同一件事▼
Global Geochemical Atlas Skill 把来自不同 科研工作者的不同 需求,Agentic-Native 的可信、可交互、可回溯、统一的动态时序 地球化学元素研究流程。
先从一句提问说起:“帮我画一张全球土壤砷分布图,顺便告诉我哪里异常。”听起来像个检索问题。但放进真实的研究团队,它马上变成四个更难的问题——地球化学家会问:几十个调查、三种单位、五种消解方法,这些数字能放进同一张图里比吗?环境监管会问:西南的砷高出好几倍,是污染超标还是地质本底?数据管理员会问:一九七八年的老记录,检出限和坐标系还查得到吗?评审专家会问:AI 给的每个数字,出处在哪,敢引用吗?这四个问题指向同一件事:AI 读出数字,不代表拿到了可比较、可复用的科学数据。所以我们做的这个 Skill,不是输入元素名、输出一页图——它把一句自然语言问题,转成一条可回溯的地球化学证据链。接下来先看赛题怎么落地。
02 · TASK BREAKDOWN / DATA SOURCES
赛题要求,逐条落地
自动采集 ACQUIRE
岩石 土壤 沉积物 水体 元素含量 采样坐标 地质背景 分析方法
科学处理 STANDARDIZE
单位统一 空间匹配 质量控制 来源追溯 原始值永不覆盖
研究输出 VISUALIZE
按元素 / 区域 / 地质单元 / 样品类型 全球与区域分布图 热力图 元素组合对比 异常富集 / 亏损识别
最新世界图谱已接入 36 个正式来源 · 199,723 条测定 · 覆盖六大洲、两极与全球海洋 · 岩石 / 土壤 / 沉积物 / 水体
欧洲 · 9 FOREGS ×6 · GEMAS 农牧土壤 MarChem 海洋 · 巴伦支 土壤
亚洲 · 13 中国 ×9 山地/大河/近海 日本 GSJ ×2 · 冻土 · 阿拉伯海
美洲 · 5 加拿大 CDoGS · USGS · WQP 亚马逊 · 巴西东北 土壤剖面
非洲 · 大洋洲 · 4 AfSIS 土壤 · 北非土壤 澳大利亚 NGSA ×2 含 Hg
全球 · 极地 · 5 GEOTRACES 海水 · GEMStat 淡水 GEOROC ×3 南极/太古宙
交付 1 可交互元素分布地图
交付 2 标准化地球化学数据库
交付 3 数据来源与置信度说明
交付 4 异常区域识别结果
交付 5 可复用 Skill 文档
创新 ① 完整科研流程:图谱 → 发现 → 论文
创新 ② 时序演化图谱:地质富集 or 工业活动
赛题要求三件事:第一,从公开文献和开源数据平台自动采集岩石、土壤、沉积物、水体四类介质的元素含量、采样坐标、地质背景和分析方法;第二,完成单位统一、空间匹配、质量控制和来源追溯;第三,按元素、区域、地质单元和样品类型生成全球或区域分布图、热力图与元素组合对比,并识别异常富集与亏损区域。最新世界图谱已接入三十六个正式来源、近二十万条测定,覆盖六大洲、两极与全球海洋:欧洲 FOREGS 六介质与 GEMAS,亚洲十三个来源里中国占九个,美洲从加拿大到亚马逊,非洲 AfSIS、澳大利亚 NGSA,再加 GEOTRACES 海水、GEMStat 淡水和 GEOROC 极地岩石。同一次 Skill 运行产出五项赛题交付,另外还有两项创新:从图谱到论文的完整科研流程,以及回答“地质富集还是工业活动”的时序演化图谱,后面都会展示。
03 · DELIVERABLE 1 / INTERACTIVE ATLAS
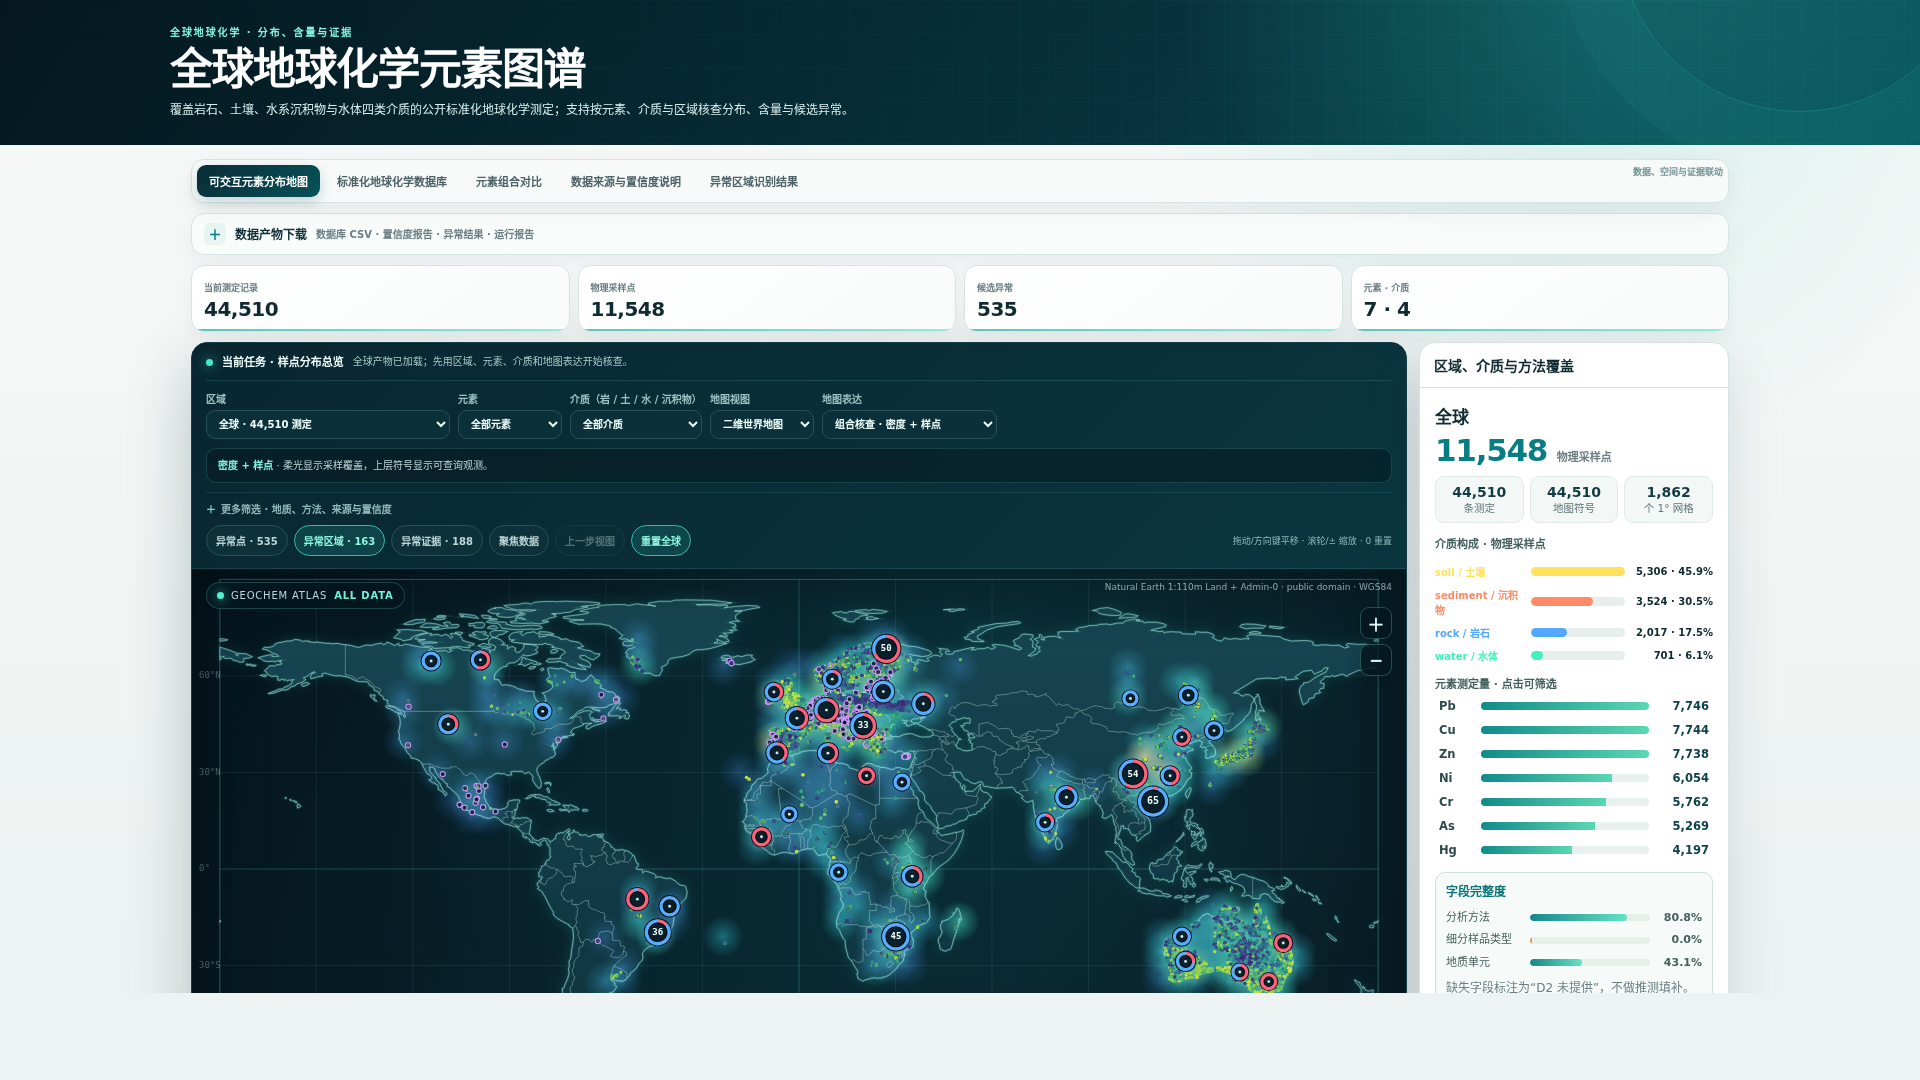
交付 1 · 可交互元素分布地图 分布地图 数据库 组合对比 来源置信 异常识别
3D 地球仪 · 同一份数据 · 点击放大 ↗
现场操作说明
① 选择范围 按元素、区域、地质单元和样品类型筛选
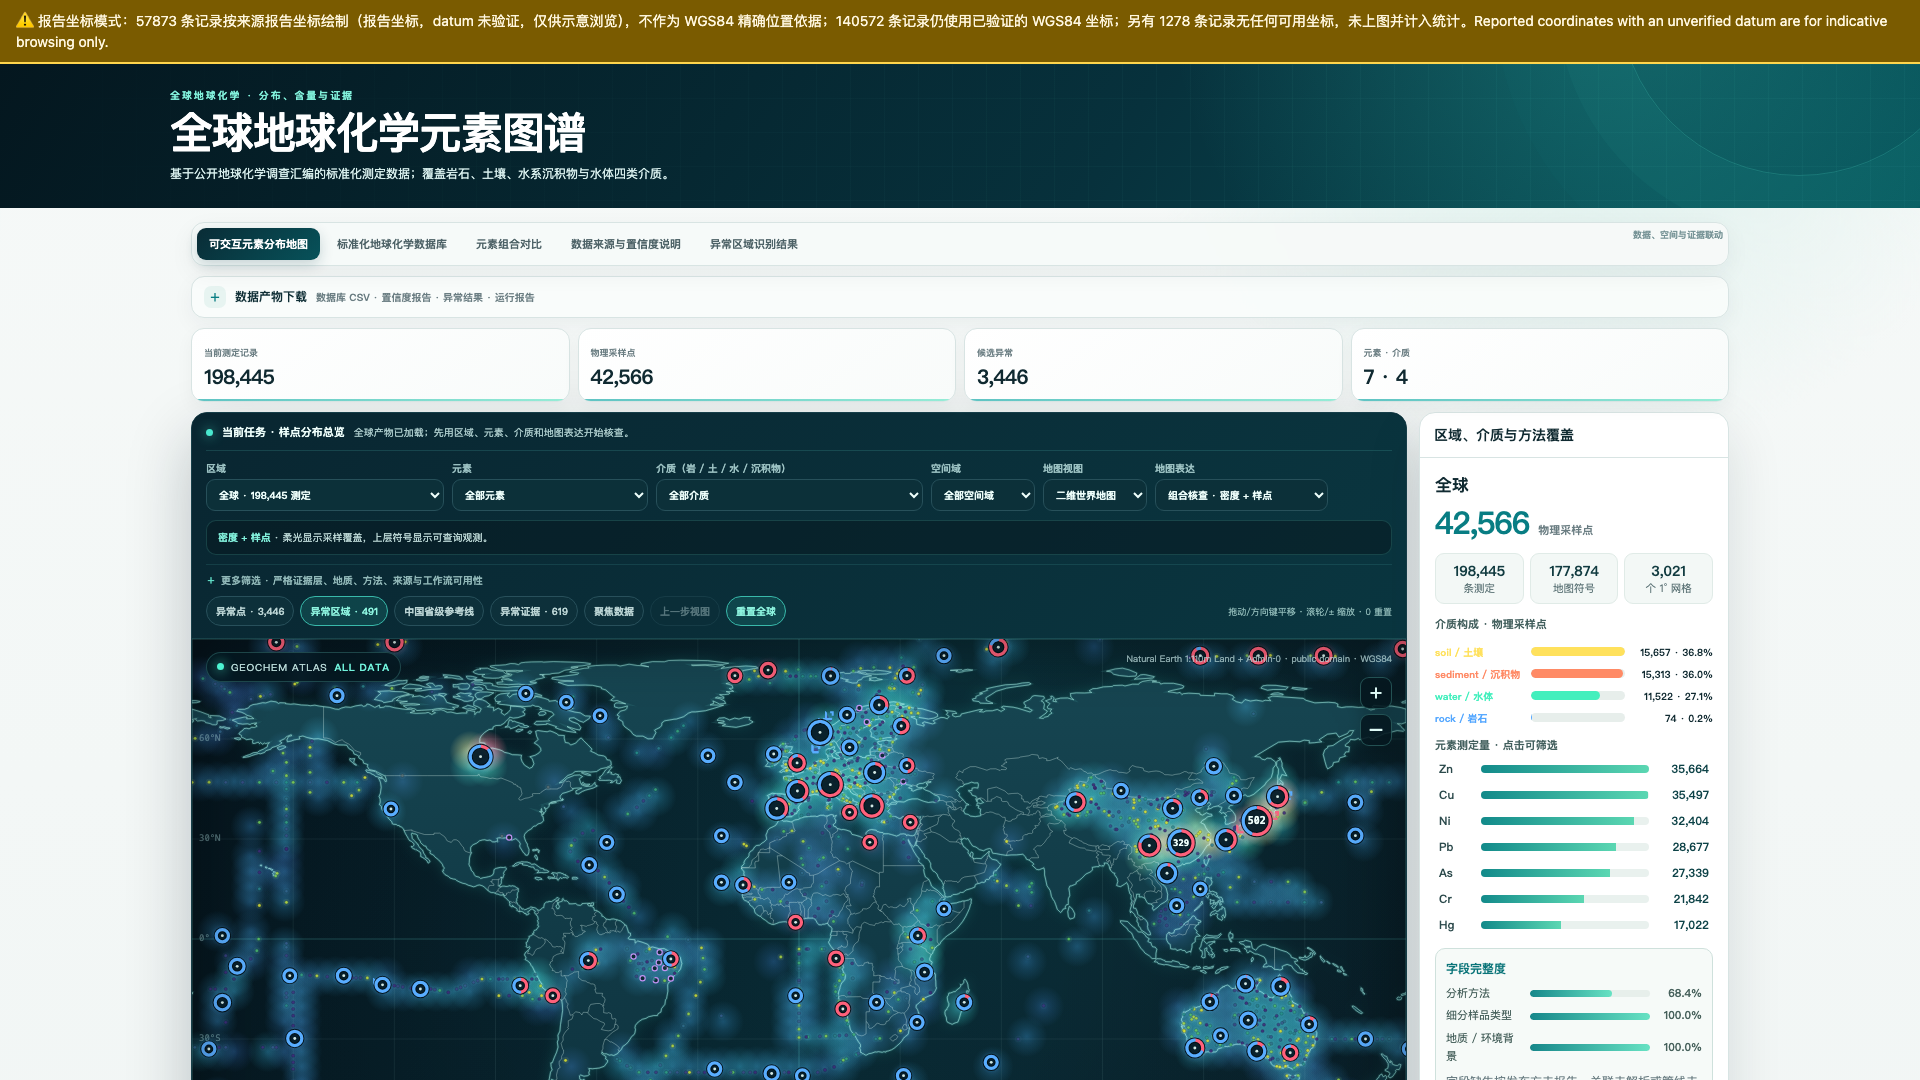
② 查看分布 颜色表示采样密度,圆点表示汇总后的采样位置
③ 查看记录 点击点位可查看对应的原始测定
页面包含分布图、数据库、组合对比、来源说明和异常识别五个视图,切换时保留当前筛选条件。
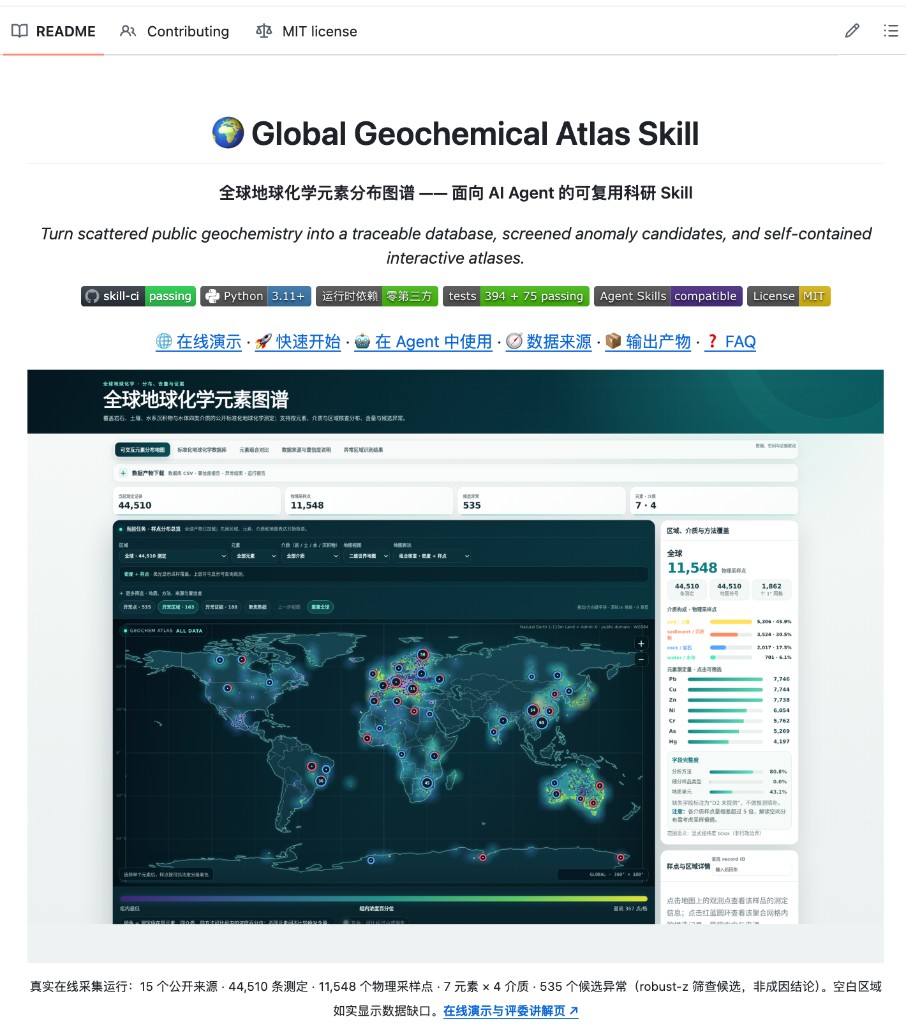
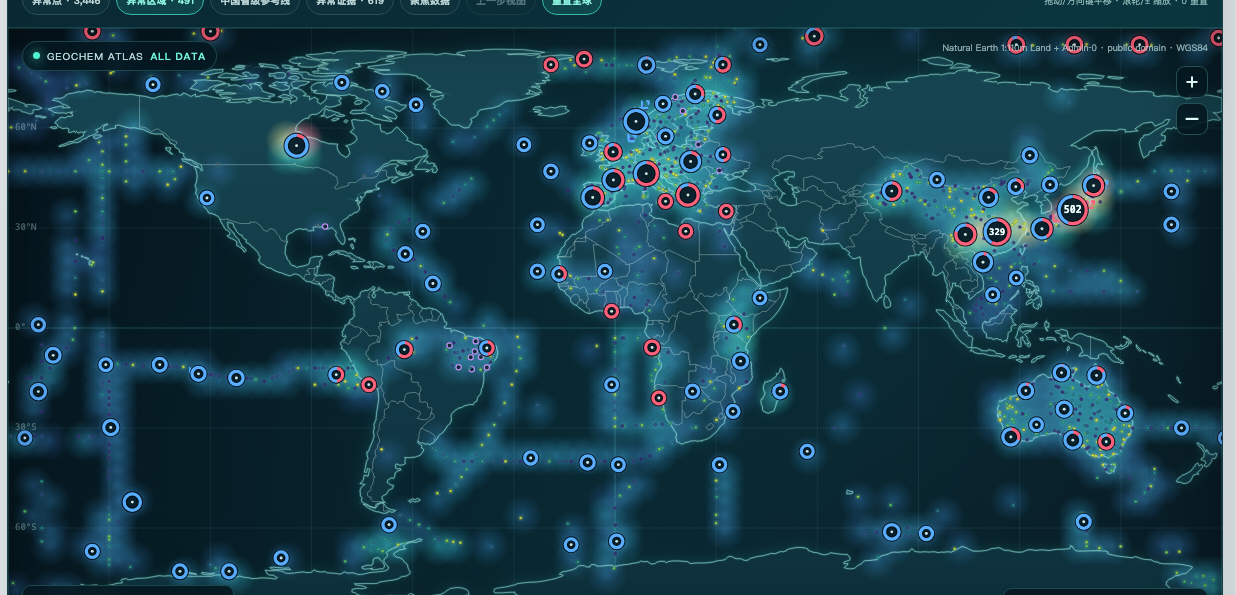
本次运行共有 198,445 条测定可上图,覆盖 42,566 个采样点;另有 3,446 条异常记录等待复核。
支持按元素、区域、地质单元和样品类型生成全球或区域分布图;网页和交互数据可离线使用;没有数据的区域保持空白,不使用插值补齐。
第一项交付:可交互元素分布地图,这是最新一次运行的界面实拍——十九万八千多条可上图测定、四万两千多个物理采样点。各位评委现场就能上手:想看哪个元素、哪片区域、哪类样品,随手筛;图上颜色深浅是采样密度,圆点是聚合后的点位;点任何一个点,能一路追到那条原始测定是谁测的、怎么测的。右侧是同一份数据的三维地球仪,可拖动旋转。特别说一句:整张图谱压在一个 HTML 文件里,拷进 U 盘就能带走,断网照样全功能操作;图上哪里空白,就是哪里真的没数据——我们不靠插值把图补漂亮。
04 · DELIVERABLE 2 / STANDARDIZED DATABASE
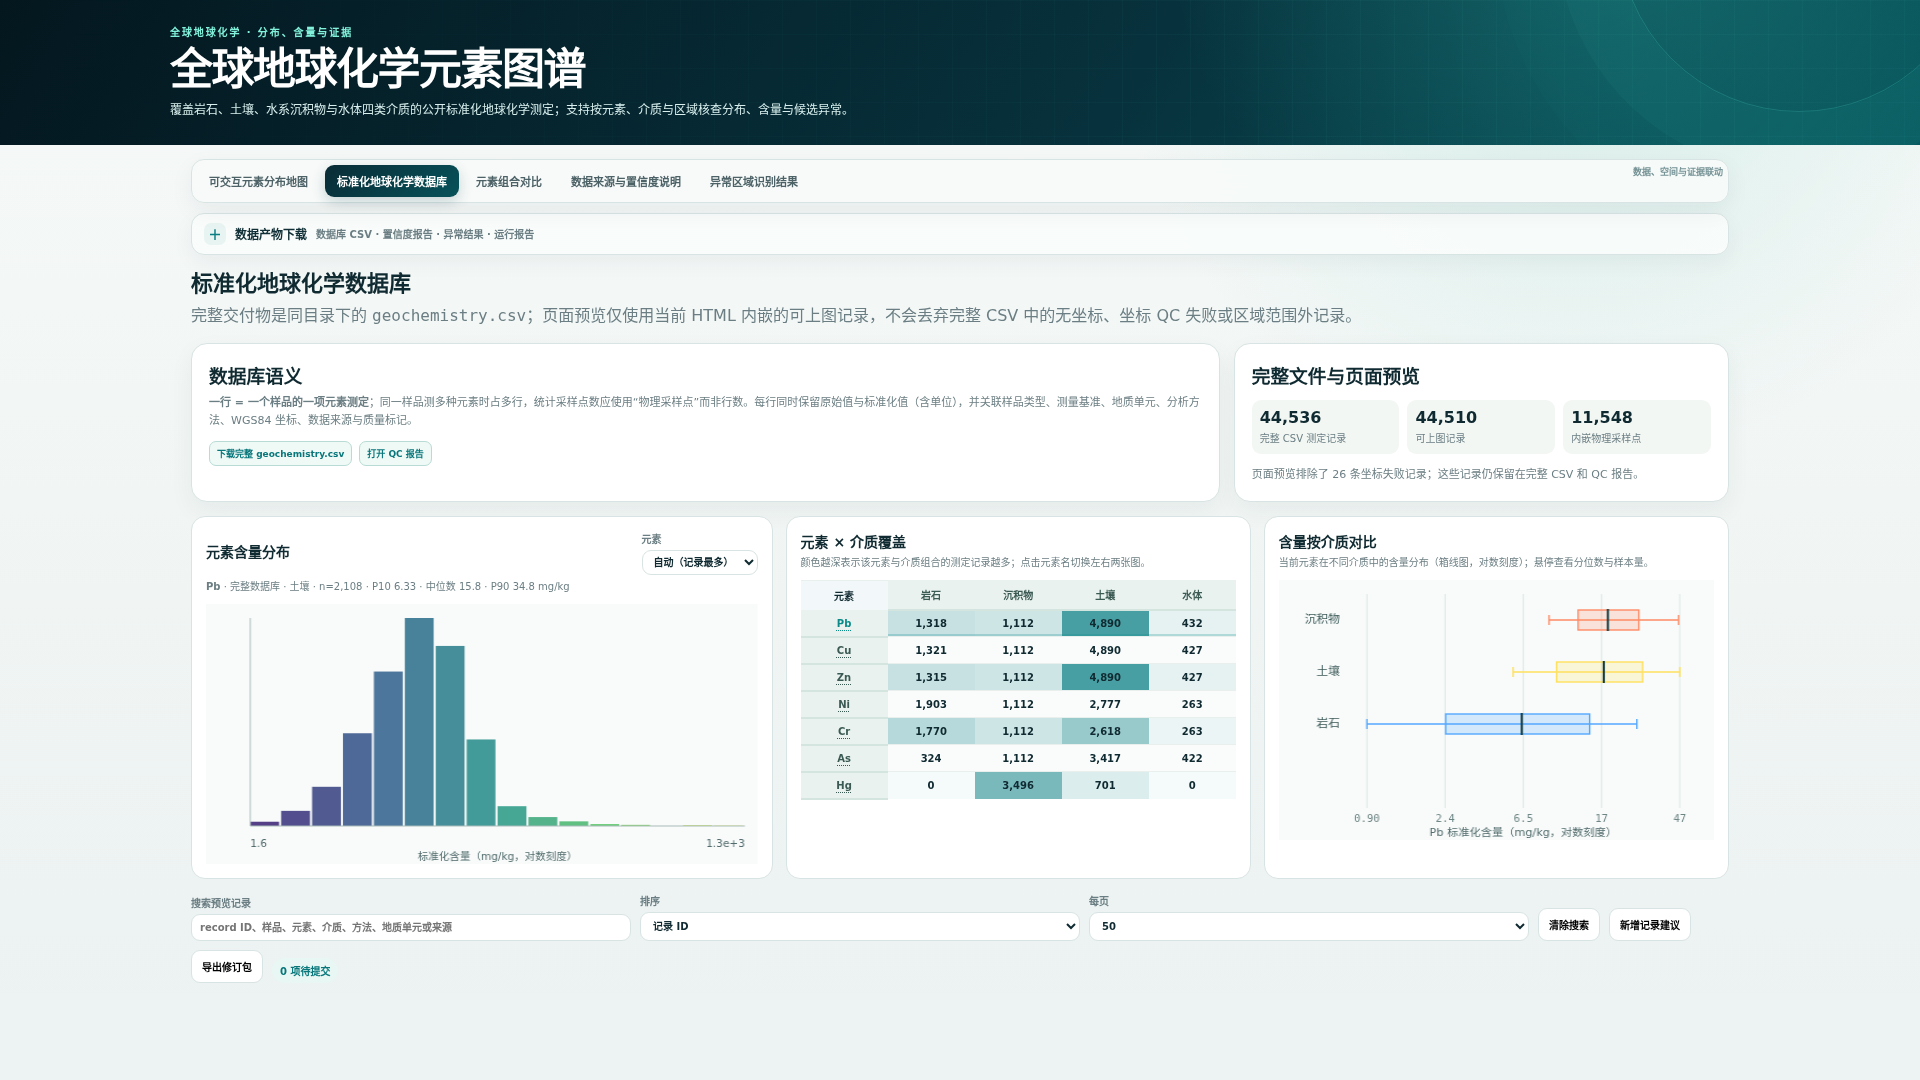
交付 2 · 标准化地球化学数据库 分布地图 数据库 组合对比 来源置信 异常识别
数据采集项:每条检测记录应包含的核心信息
记录编号 每条检测的唯一标识 样品编号 对应具体采样样品 检测元素 如砷、铅、锌 样品类型 土壤、岩石、水体等 原始检测结果 数值和原始单位 结果状态 未检出、低于限值等 统一后的数值 换算为统一单位 单位换算信息 换算方法与倍数 检出限信息 检出限与删失状态 采样位置 经纬度与坐标系 位置精度 坐标误差范围(米) 地质背景 所在岩性或地质单元 采样时间 采样年份与日期——支撑时序演化图谱与成因归因分析
怎么用 · 一行一条测定
① 检索 record_id / 元素 / 介质 / 地质单元
② 读行 标准值 mg/kg · WGS84 · 检出限 qualifier · 置信度
③ 导出 完整 geochemistry.csv 与 QC 报告
原始值永不覆盖: original 与 normalized 双列并存,换算因子、公式与 QC 另列保存。
“As = 56 mg/kg”本身不是科研数据:哪个样品?什么介质?什么消解方法?检出限多少?来源哪一行?——绑定这 40+ 字段后,数字才可比较、可复用。
全库 199,723 条固定记录:单位统一 mg/kg、坐标统一 WGS84;删失值不置 0、不用 LOD/2(Helsel 2012)。长表语义对齐 ODM2,字段映射对照 EarthChem / USGS / IGSN。
第二项交付:标准化数据库。先讲一个判断:AI 从论文和数据库里读出一个数字,不代表它拿到了可以比较、可以复用的科学数据。五十六毫克每千克的砷,本身几乎没有意义——是哪个样品?土壤还是沉积物?王水消解还是全消解?检出限多少?原始来源哪一行?只有这些信息重新绑定起来,数字才从“AI 回答”变成“科研数据”。所以我们的数据库是一张四十多个字段的专业长表,一行就是一个样品的一项元素测定:record_id 全库唯一,样品可带 IGSN 国际标识;原始值和标准化值双列并存,换算因子与公式单独成列;删失值保留检出限 qualifier,不置零也不用检出限一半代入——这是删失环境数据统计的标准教科书 Helsel 的核心主张;坐标统一 WGS84 并带不确定度,地质单元来自 GLiM 全球岩性图(Hartmann–Moosdorf 2012,0.5 度)。下载的 geochemistry.csv 就是交付物本体,长表语义对齐 ODM2,不脱离专业生态。
05 · DELIVERABLE 3 / SOURCE & CONFIDENCE
交付 3 · 数据来源与置信度说明 分布地图 数据库 组合对比 来源置信 异常识别
0.98 来源证据均值 / 1
199,165 证据充分 · 99.7%
558 待补证 · 0.3%
0 证据不足 · 0.0%
每条数据从四个方面分别说明
来源是否可回溯 能否找到对应的原始记录
98 / 100 检测结果是否可用 方法与质量控制信息是否完整
81 / 100 位置是否可用 坐标和坐标系信息是否完整
59 / 100 能否直接使用 按缺失信息量估计还需多少人工复核
73 / 100
四项反映不同问题,需要分别解读。例如缺少坐标,只表示无法准确上图,不代表数据来源不可靠;这些分数也不是测量准确率。
36 个来源均记录了使用许可、数据版本和获取方式;每条数据都能追溯到原始表格或记录。
同时保留原始数值、出处位置和文件校验信息,便于复查数据来自哪里、使用的是哪个版本。
第三项交付:数据来源与置信度说明。最新版把置信度拆成四个必须分开判读的口径,这是真实运行值:来源证据九十八分——证据充分的记录占百分之九十九点七,均值零点九八;分析可用性八十一分;空间可用性五十九分;工作流可用性七十三分。为什么分开?因为空间坐标缺位不应该反过来贬低来源证据——这回答的是数据是否真实可追溯,两码事。三十六个来源全部附许可、版本与接口说明;任何一条记录都能沿证据链追到原始源行——原始值、来源 DOI 和表行位置,再到文件与运行的 SHA-256。我们如实标注:这些分数衡量工作流可用性,不等于测量正确概率。
06 · DELIVERABLE 4 / ANOMALY DETECTION
交付 4 · 异常区域识别结果 分布地图 数据库 组合对比 来源置信 异常识别
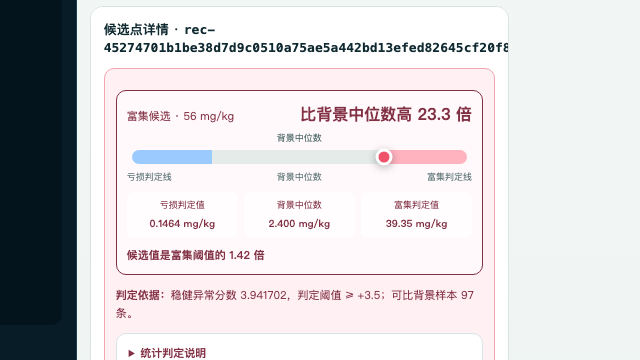
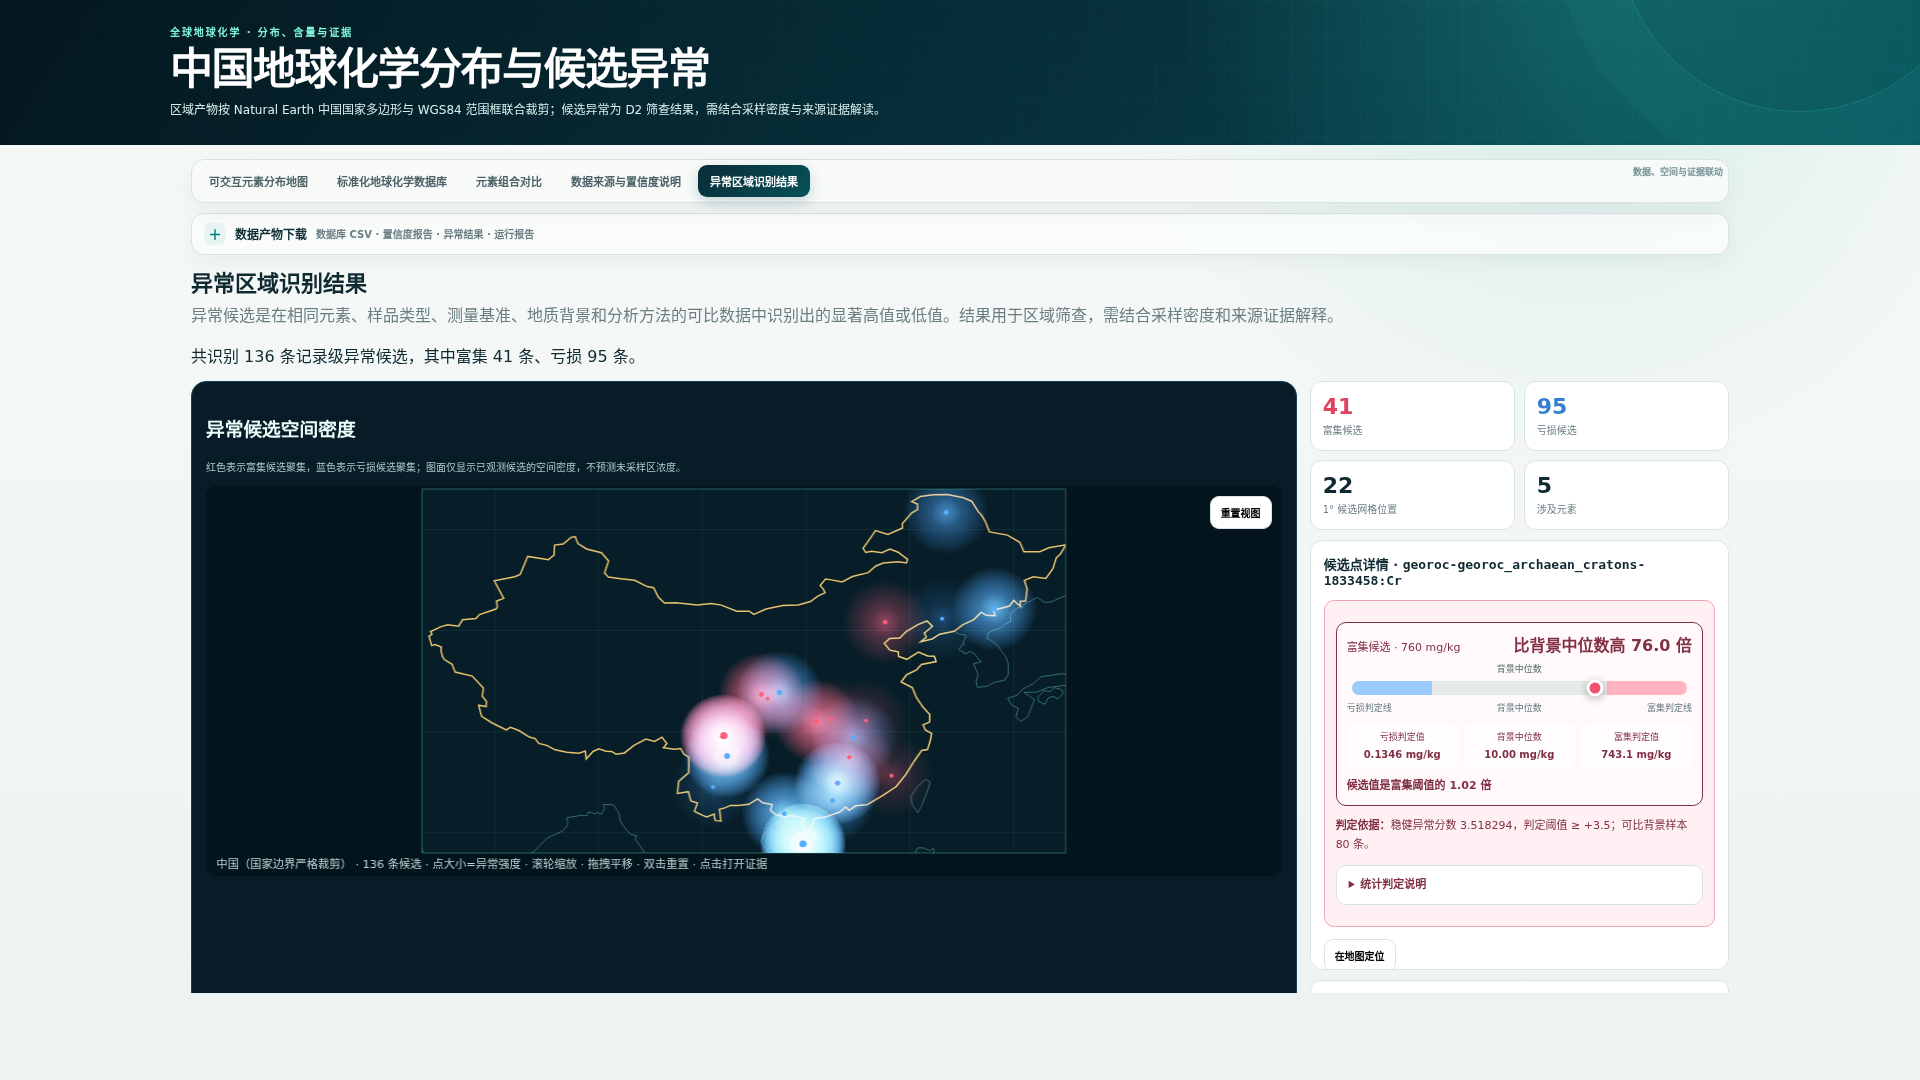
判据卡片实拍 · 比背景中位数高 23.3 倍 · 点击打开 ↗
异常记录的查看方式
① 查看分布 红色表示偏高记录聚集,蓝色表示偏低记录聚集
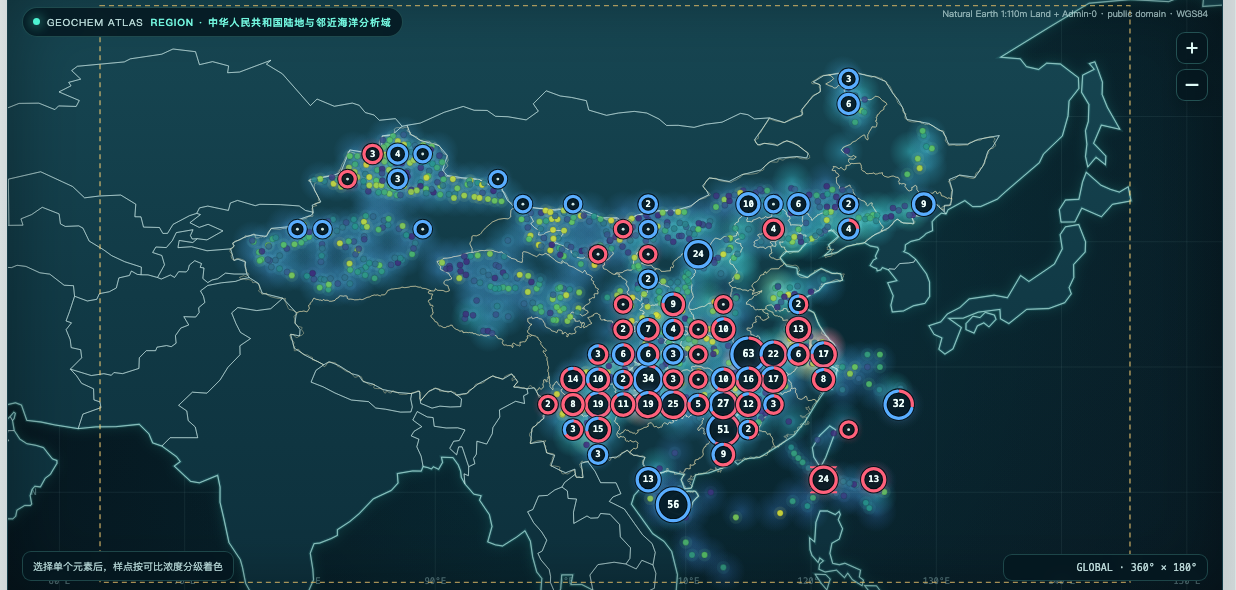
② 查看数量 本次共标出 740 条,其中偏高 386 条、偏低 354 条
③ 查看原因 打开记录卡片,查看它为什么被列为异常
判定指标均有文献依据: 修正 z 分数 ≥ 3.5 判为候选(Iglewicz–Hoaglin 1993);背景组限定同元素、同介质、同测量基准,用对数尺度中位数 + MAD 稳健估计(Reimann–Filzmoser–Garrett 2005);空间网格富集经 BH-FDR 多重检验校正 q ≤ 0.10(Benjamini–Hochberg 1995)。
偏高和偏低记录分别展示,每条记录都附有判定依据和复查入口。
这里标出的是需要进一步核查的异常记录,不代表已经发现矿化或污染;可以继续查看对应的原始数据。
第四项交付:异常区域识别结果,这是中国区域最新运行的实拍。本次共识别七百四十条记录级候选,富集三百八十六条、亏损三百五十四条;主图是空间密度,红色是富集候选聚集、蓝色是亏损候选聚集。右侧缩略图是一张真实判据卡片:这个候选五十六毫克每千克,比背景中位数高二十三点三倍,稳健异常分数三点九四,超过判定阈值三点五,可比背景样本九十七条——每个候选都能这样解释“为什么被标记”。判定口径不是我们拍脑袋定的,每一项都有文献依据:三点五的阈值来自 Iglewicz 和 Hoaglin 一九九三年的修正 z 分数标准;对数尺度加中位数、MAD 的稳健背景估计,遵循地球化学背景与阈值方法学的标准文献 Reimann、Filzmoser 和 Garrett 二〇〇五年发表在《Science of the Total Environment》的比较研究;空间网格富集用超几何检验加 Benjamini–Hochberg 一九九五年的 FDR 校正,q 不超过零点一。背景组严格限定同元素、同介质、同测量基准——两个不同消解方法测出的数字,数学上能比大小,科学上不能比高低。我们如实标注:候选不等于矿化定论,复核链路直达原始记录。
07 · DELIVERABLE 5 / REUSABLE SKILL
交付 5 · 可复用 Skill 文档:四层设计
SKILL 格式 Agent Skills 公共子集,一份 Skill 多平台复用
OPENCODE 隔离评测与 Skill 挂载,已实测验证
CODEX · CLI · CI 普通文件 + 命令即可调用,零专有 API
工作流程 SKILL.md任务步骤与判断规则 整个任务分为9 个阶段 ,逐步执行。每一步都写清需要什么、产出什么,以及失败后如何处理。
参考资料 references/科学规则与数据说明 数据格式、科学判断标准和数据来源要求分别保存,使用时再读取。
处理脚本 scripts/可检查的计算与处理 单位换算、坐标处理、质量检查、异常识别和地图生成均由脚本完成,并可单独测试。
示例与测试 fixtures + tests检查结果能否重复得到 使用真实数据样例重复运行,并比较使用 Skill 前后的结果,检查流程是否稳定有效。
第五项、也是比赛的最终交付物:可复用 Skill 文档。它的核心不是长提示词,而是四层结构。SKILL.md 只保留九阶段状态机、决策门和失败状态;references 维护 JSON Schema、科学规则、来源准入,以及 EarthChem ECL、USGS AGDB2、ODM2、IGSN/DataCite 的专业字段映射;scripts 把单位、坐标、QC、异常和地图变成确定性执行;fixtures 与评测则证明可复现和真实提升。格式采用 Agent Skills 公共子集,OpenCode 冻结环境评测已接入;Codex、命令行和 CI 通过普通文件与命令接口调用。
08 · MECHANISM OVERVIEW / MODEL PROPOSES, CODE DECIDES
Global Geochemical Atlas · Skill 机制图
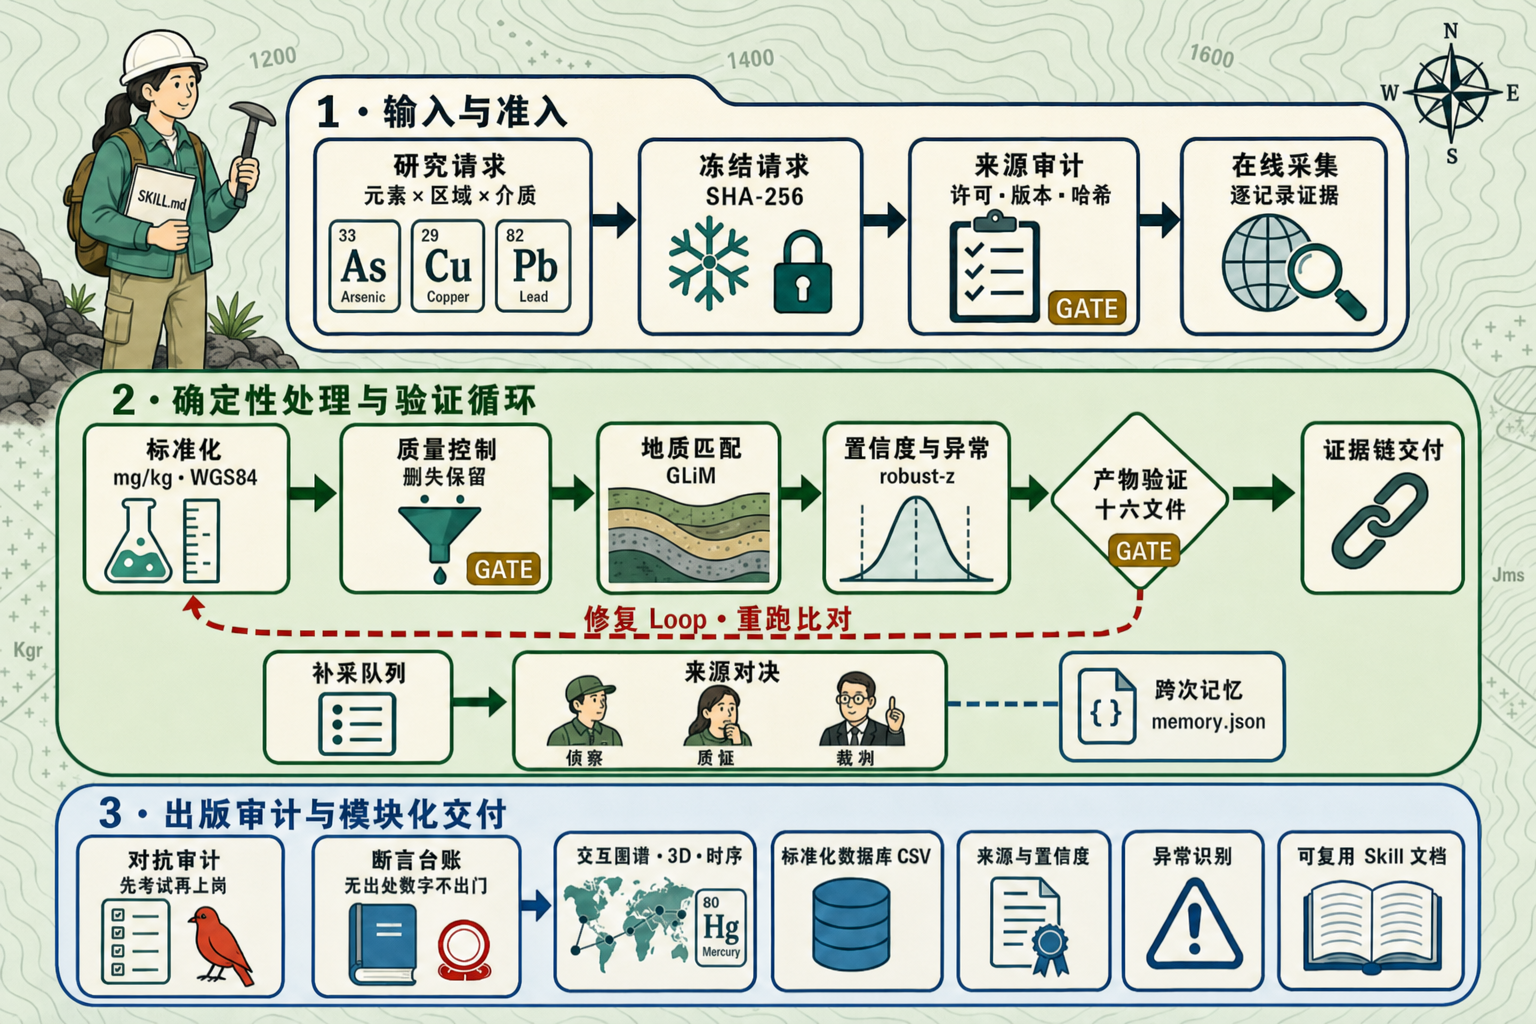
数据采集 36 个来源 逐一登记编号、许可与版本;任务请求先做 SHA-256 指纹 冻结,来源过许可、版本、哈希三查后才允许采集。
数据处理 标准化、质量控制、地质匹配、置信度与异常识别按固定顺序执行,产物对照 16 项文件要求 逐项核对。
Loop 与跨次记忆 核对不通过就修复重跑;每个来源的成功率和失败原因写入记忆文件,下次运行优先用可靠来源、跳过屡次失败的来源 。
对抗审计 侦察、质疑、裁判三个角色相互独立 :一方提出候选,一方专挑问题,最后按事先写明的规则打分裁决。
任务与检验分离 模型只负责提出候选和修改建议,采不采用由脚本按明文规则判定 ——这条原则贯穿以上全部模块。
这是整个 Skill 的机制图,五个模块。第一,数据采集:36 个来源全部在文档里登记编号、许可和版本,任务请求先做 SHA-256 冻结,来源过许可、版本、哈希三道检查才允许采集。第二,数据处理:标准化、质量控制、地质匹配、置信度与异常识别按固定顺序执行,产物对照十六项文件要求逐项核对。第三,Loop 与跨次记忆:核对不过就修复重跑,每个来源的成败记录写入记忆文件,下次运行优先用可靠来源、跳过屡次失败的来源——运行越多,采集越准。第四,对抗审计:侦察、质疑、裁判三个角色互相独立,提候选的不管裁决,裁决只看明文规则。第五,任务与检验分离:模型只提案,采不采用由脚本判定。这条原则贯穿全部模块,下一页展开中间的执行内核。
09 · SKILL INTERNALS / STATE MACHINE × ITERATION LOOP
Skill 的 Loop 状态机
往前走:九个步骤,三道门 · 一步也不跳
01–03 定题取材先把问题说清,再查文献、找数据
04–06 整理校核清洗数据,把单位、坐标和地质背景逐项对齐
07–09 结论自查看证据够不够,再成稿、复核、交付
01 锁定问题 freeze
02 审查数据来源 gate·准入
03 取数并留证据 acquire
04 筛掉不合格记录 filter
05 校单位、查坐标 gate·QC
06 对上地质底图 GLiM
07 打分、找异常 robust-z
08 产出 16 项文件 build
09 逐项验收 gate·验证
回头修:第 09 步验收不过,怎么办?
09 验收不过 → 进入 ①
① 列清问题 · validate 接住第 09 步的验收结果:16 项产物哪里没过,一条条列出来
逐条登记
② 记在案 · backlog 每条都写进 iteration_backlog:修什么、怎么修,先说清楚
按登记的方法修
③ 对症修 · route 缺证据就补证据,缺规则就补规则;没登记的,一律不碰
修完重跑
④ 再验收 · rerun+diff 重跑一遍,按 item_id 核对老问题有没有消失
⑤ 沉淀进跨轮记忆库 · memory 缺某类证据、介质或元素数据量不平衡这类一轮修不完的缺口,写入机制总图里的 memory;下一轮运行先读记忆,优先补齐
Skill 先沿九步向前走:锁定问题、审查数据来源、取数并留证据;再筛掉不合格记录、校单位查坐标、对上地质底图;最后打分找异常、产出 16 项文件、逐项验收。真正的转折点在第 09 步:验收不过,就进入四步循环——列清问题、记在案、对症修、再验收;修完不是继续往后走,而是回到 09 重新过关。底层仍有三道科学门:来源准入、背景组 n ≥ 20、出图验证。循环最多 2 轮,仍不过就标记 needs_human_review。更关键的是第五步:一轮修不完的缺口——缺某类证据、介质或元素数据量不平衡——会沉淀进跨轮记忆库 memory,下一轮运行先读记忆、优先补齐。它允许失败,但不允许悄悄失败,也不会白白失败。
10 · LOOP EVIDENCE / REAL ITERATION BACKLOG
高质量数据的 Loop 自动修复机制
为什么要记账
自动清洗最怕悄悄丢数据 、悄悄改数值 。所以每个问题都记进 iteration_backlog.csv,分三路处置:能修的自动修、要判断的转人工、科学事实原样保留——不遗漏,不歪曲 。
质检账本 · 本次世界图谱运行的真实片段
这次运行记下 114,807 个问题:能自动修的 89,207 · 要专家过目的 25,352 · 属于科学事实的 248 —— 没有一条被悄悄扔掉
问题编号 严重度 处置去向 问题是什么 处置规则(账本原文) ITER-6c1ada8d 警告 自动修复 方法适用范围没写清METHOD_SCOPE_MISSING 依据来源证据标注方法适用范围,不得把数据集级方法伪装为记录级 ITER-f3d908d9 错误 自动修复 单位换算失败NORMALIZATION_FAILED 检查单位词表与换算公式;不能证明可换算时保留失败,不得猜值 ITER-67e45f9e 提示 转人工 缺地质背景GEOLOGIC_CONTEXT_MISSING 允许时执行空间匹配并记录地图源与方法;否则保留缺失 ITER-4329e257 错误 自动修复 坐标不可用COORDINATE_UNUSABLE 从原始来源恢复坐标与 CRS;只有区域名称时保留缺失,不得填质心 ITER-d7c634bd 提示 科学事实 低于检出限CENSORED_OBSERVATION 删失观测保留 qualifier 与检出限,不等同于零,不计为失败
自动修复 · 89,207补来源证据、改字段映射就能修好的,按问题类型派给对应脚本处理。
转人工 · 25,352坐标系、方法语义这类要专家拿主意的,自动修复到此止步。
科学事实 · 248删失值、背景样本太少——这是数据本来的样子,不算失败,更不许编个数“修好”。
上一页说 loop 每轮都在登记问题,这一页解释为什么要记账:自动清洗数据最怕两件事——悄悄丢数据、悄悄改数值。所以我们规定:发现的每个问题都记进账本,怎么处置写明白。这次世界图谱运行记下了十一万四千八百零七个问题,没有一条被悄悄扔掉。屏幕上是账本的真实片段:方法适用范围没写清、单位换算失败、缺地质背景、坐标不可用、低于检出限——每一条都有编号、严重度、去向和处置规则。三类分流:八万九千多个能自动修,两万五千多个要专家过目,还有二百四十八个是数据本来的样子,不算失败,更不许编个数“修好”。修复只出新版本,旧数据一个字节不动。账本里最难修的一类问题是“这个区域根本没数据”——下一页讲我们怎么补。
11 · MECHANISM / ADVERSARIAL SOURCE AUDIT
数据的对抗审计机制
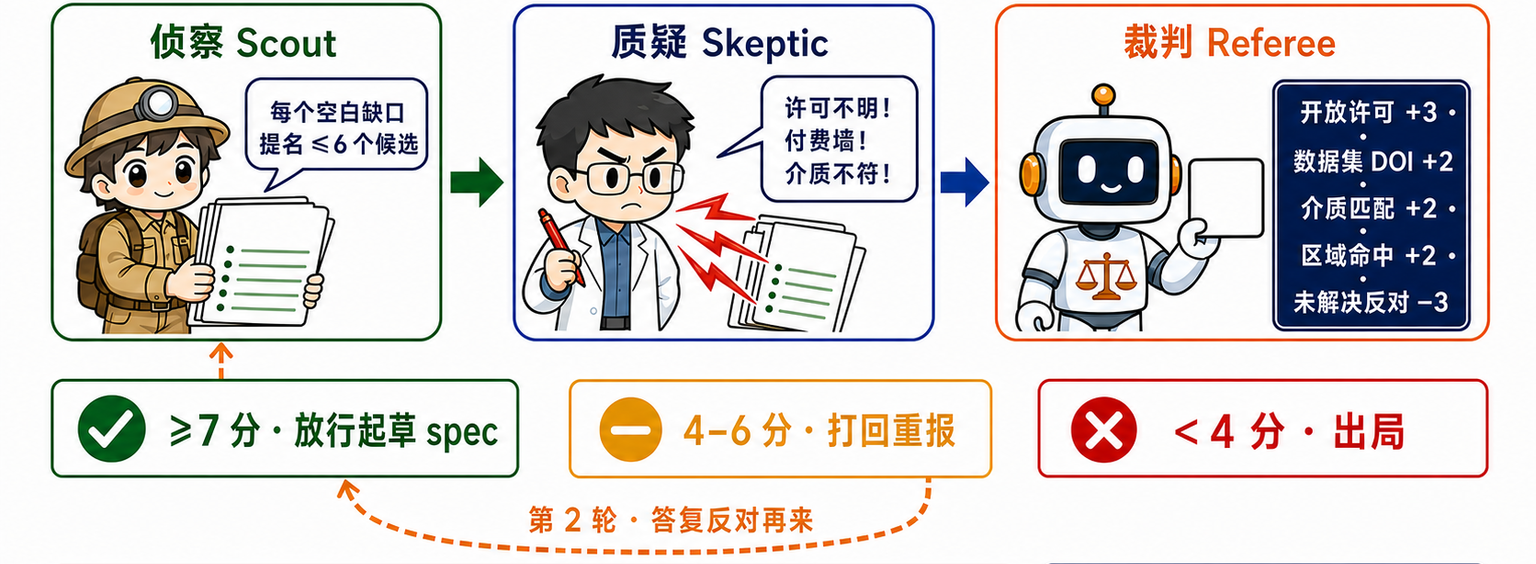
第一层 · 侦察员提候选 根据缺口账本,面向空白区域广泛提名新来源;只提名,不审批 。
第二层 · 质疑员提反对意见 独立模型逐条检查许可、介质、区域 ;只指出问题,不打分、不决定。
第三层 · 裁判按规则算分 确定性代码不生成意见,只执行明文计分牌:≥7 起草接入,4–6 补材料,<4 淘汰。
三层独立 · 人工终审 三种角色互不替代;评分通过只取得起草资格,正式入库仍须负责人确认。
遇到数据空白,侦察模型负责尽量多提候选。第二个模型是质疑员:它只围绕许可、介质和区域提出反对意见,不打分,也不做决定。真正拍板的裁判不是模型,而是一段确定性代码;它不生成新意见,只把双方材料代入明文计分牌,算出接入、补材料还是淘汰——开放许可加三,DOI 可访问加二,稀缺样品加二,填补空白加二,质疑未答复减三。达到 7 分也只够起草接入方案,正式入库仍要负责人签字。这一页,就是“模型提案,代码裁决”的缩影。
12 · MECHANISM / CLAIM LEDGER
最后一层检查:数据非可信不可用
它不是再分析一遍数据,而是给报告做对账 :写进报告的每个数字,都必须回到运行产物中找到证据。
① 报告准备写什么?
本次固定审计运行自动抽取 8 项可核验事实
标准化记录 1,422 条
覆盖元素 Cu · Pb · Zn
覆盖介质 土壤
有效坐标比例 0%
工作流可用性 0.59
候选异常 16 条
删失记录 0 条
正式采用来源 1 个
→
② 代码逐项核对
每一项都执行同样的三步检查
找出处 定位到具体产物、字段路径和文件 SHA-256
重新计算 回到 CSV / JSON 独立重数、重算,不能照抄报告
检查有没有说过头 “异常”必须写成“候选异常”;可用性不能写成正确概率
→
③ 本次对账结果
只有通过或收窄口径后,才能写进报告
6 项数字一致,直接通过
2 项数字没错,但必须限定表述
0 项无证据流出
✓ 数字核对一致 报告写 1,422 条,CSV 重数也是 1,422 条。
◐ 数字对,表述要收窄 16 条只能写“候选异常”,不能写成污染定论。
✕ 假数字会被拦下 校准时故意插入 25,000;产物查无此数,立即驳回。
这一页不是再分析一次数据,而是给报告做出门前对账。先看左边:固定审计运行准备写八项事实,包括一千四百二十二条记录、三种元素、土壤介质、坐标比例、工作流可用性、十六条候选异常、删失记录和来源数。中间的代码对每一项做三件事:找到具体产物和哈希,回到 CSV 或 JSON 独立重算,再检查措辞有没有超过证据。结果在右边:六项直接通过,两项数字没错但必须收窄说法——可用性不是正确概率,异常只是候选;零项无证据数字流出。底下三个例子对应这三种出口。校准时我们故意塞入二万五千这个假数字,产物里查不到,系统会立即驳回。
13 · RESULTS / WORLD · CHINA · EUROPE · US
同一套方法在四个地区的实际运行结果
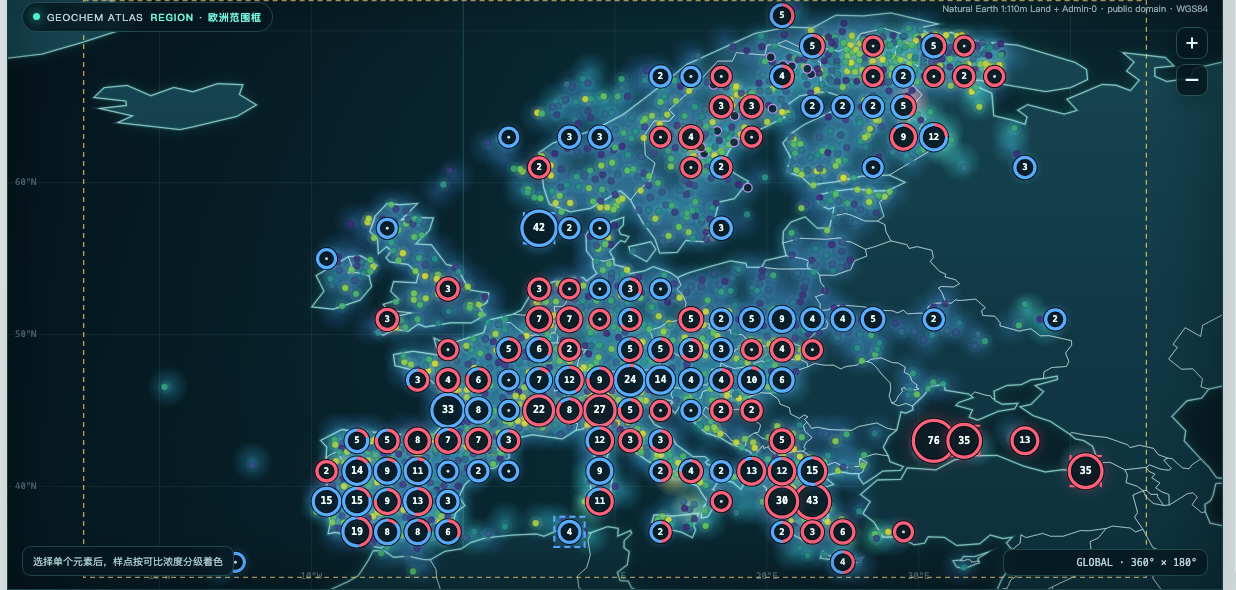
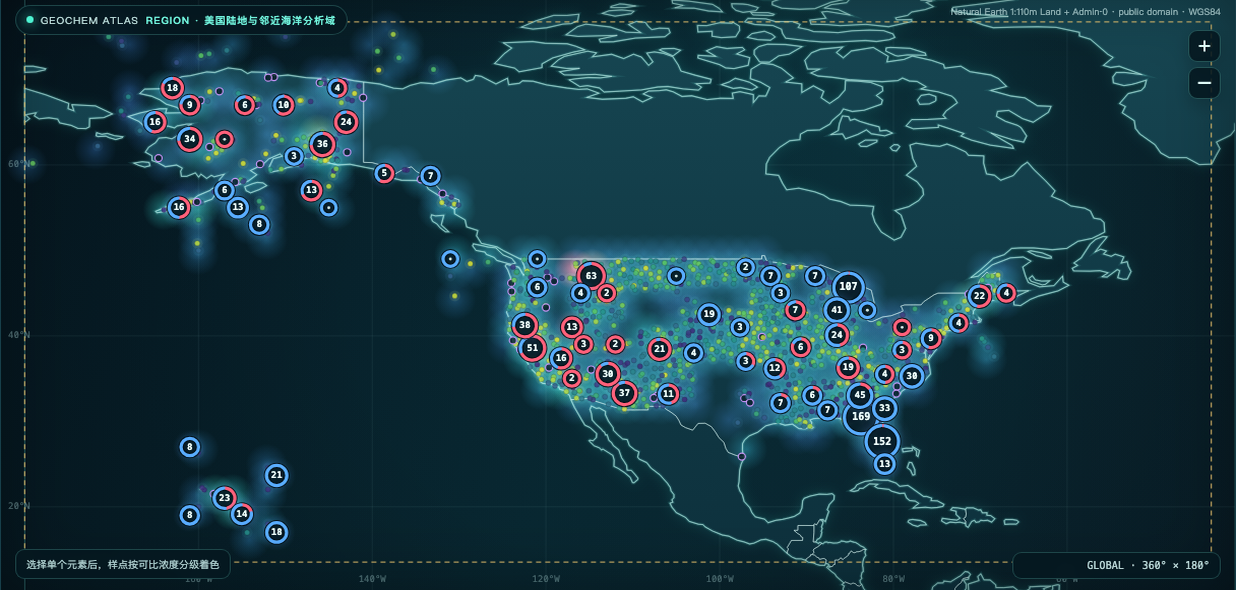
机制讲完,看结果:同一套 Skill 换个分析域就能再跑,这四张卡片都是实测界面。世界产物十九万八千多条可上图测定、四万两千多个物理采样点、三千四百多个候选异常;中国区域两万四千多条测定、七百四十个候选异常,富集与亏损分开;欧洲四万七千多条测定、九百八十一个候选异常;美国九万一千多条区域测定、两万四千多个物理采样点、一千三百九十八个候选异常,来源覆盖 USGS 全国地球化学库、CONUS 土壤和各州水质门户。每张卡片都能现场点开对应的交互图谱操作。这些是区域产物口径,和全库总数不混算。
14 · SKILL IN ACTION / QWEN3.8-MAX × OPENCODE
运行实况:Qwen3.8-Max 挂载 Skill 干活
1 读 SKILL.md · 冻结请求freeze request
2 路由与审计来源source_router · source_audit
3 采集与逐记录证据run_atlas_request
4 汇总与确定性过滤deterministic filter
5 标准化 · 单位坐标 QCstandardize_geochemistry
6 地质空间匹配GLiM geo match
7 置信度与候选异常confidence · robust-z
8 可视化与十六文件产物build_interactive_map
9 验证 · loop 收敛validate_outputs · backlog
opencode — qwen3.8-max · skill: global-geochemical-atlas
$ opencode run -m qwen3.8-max "全球 Cr·Cu·Ni·Pb·Zn 元素图谱与异常筛查"
来源 15/15
可上图测定 44,510
综合置信度 0.874
候选异常 535
产物 16/16 · PASS
这是通用 Agent 用我们 Skill 干活的实况:Qwen3.8-Max 在 OpenCode 里挂载 global-geochemical-atlas,接到任务后自己读 SKILL.md、进入九阶段状态机——路由审计来源、采集带证据的测定、确定性过滤、标准化、地质匹配、置信度与异常、生成产物、验证收敛。注意日志中间那两行 loop:第一次验证发现两项不通过,问题登记进账本、定向修复、重跑比对,第一轮就收敛归零——这就是前面讲的修复循环在真实运行中的样子。右侧产出实时就绪:交互图谱、标准化数据库、异常识别,五项交付齐活。关键分工是:模型只做编排与解读,单位、坐标、QC、异常判定这些科学计算全部由确定性脚本完成,所以换任何兼容 Agent 结果一致。我们做过 OpenCode 有无 Skill 的对照评测,提升是实测的。
15 · TEMPORAL ATLAS / GEOGENIC VS ANTHROPOGENIC
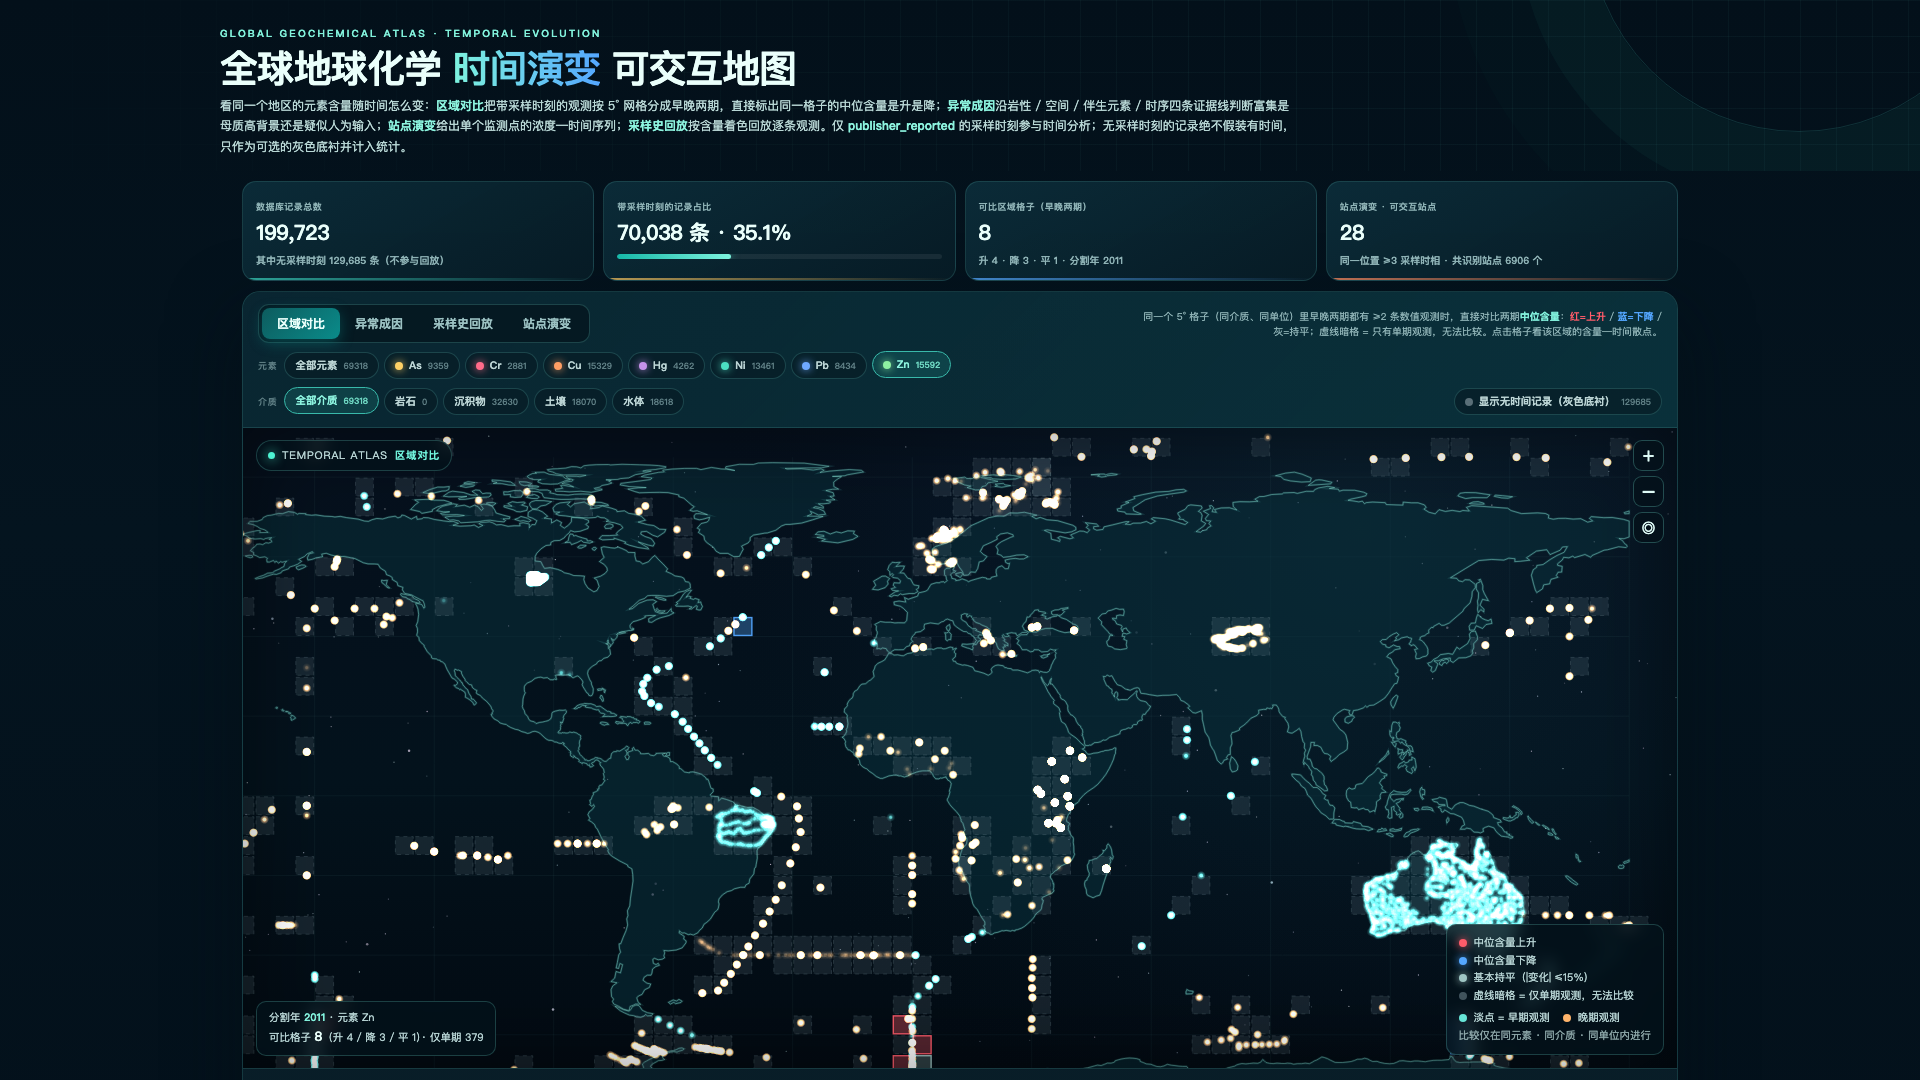
时序演化图谱:地质富集,还是工业活动?● 1986–2024 自动播放中 区域对比 异常成因 采样史回放 站点演变
三步逻辑 · 从时间戳到成因判断
① 时间入库 标准化数据库带采样时间:70,038 条 · 35.1% · 1986–2024
② 时序归因 同一格网早期 vs 晚期:母质高背景,还是后天输入?
③ 交互回放 区域对比 / 异常成因 / 采样史回放 / 站点演变
环境监测最大的争议是“超标还是高背景”: 如西南土壤砷本底就高,按 GB 15618-2018 通用筛选值口径会误判为异常——时序证据把两者分开。
富集候选成因归因(实测)
母质高背景 · 地质本身 125
疑似人为输入 · 工业活动 83
证据不足 · 暂不判定 1,026
混合叠加 · 难以分开 256
亏损候选 · 不做归因 1,958
创新之二:时序演化图谱,回答环境监测最大的争议——“超标还是高背景”。比如西南地区土壤砷本底就高,按国标 GB 15618-2018 的通用筛选值口径会被误判成异常——这也是国内高背景区研究反复讨论的问题。逻辑三步:第一步,标准化数据库本来就带采样时间,七万条带时间戳,覆盖一九八六到二〇二四;第二步,异常识别叠加时序信息做成因归因——同一格网早期与晚期对比,判断富集是母质先天决定,还是工业排放后天造成;第三步,做成可交互的时间演变地图——大家现在看到时间轴已经自动在走,这就是采样史回放;四个视图:区域对比、异常成因、采样史回放、站点演变。右下是实测归因:母质高背景一百二十五个,疑似人为输入八十三个,证据不足一千零二十六个——分不清就不下结论,只报缺口。
16 · FROM ATLAS TO PAPERS / FULL RESEARCH WORKFLOW
从图谱、发现到论文:一条完整的科研流程
① 图谱扫描 · 发现现象 在冻结数据上扫遍元素 × 介质 × 区域,让反常信号自己冒出来
→
② 提出选题 · 31 个候选 把现象写成可检验的问题,按证据排队,不靠人工点题
→
③ 试点验证 先用小成本验一遍,站不住的题当场停掉
→
④ 复现闸门 · 文献核对 已知结论复现不过,就没资格谈新发现
→
⑤ 多角色接力 · 成稿 5 篇 统计、文献、写作、绘图各司其职,把题目做深
→
⑥ 独立审稿 · 缺口回灌 换一类模型做 7 项检查,缺口送回采集队列 ↺
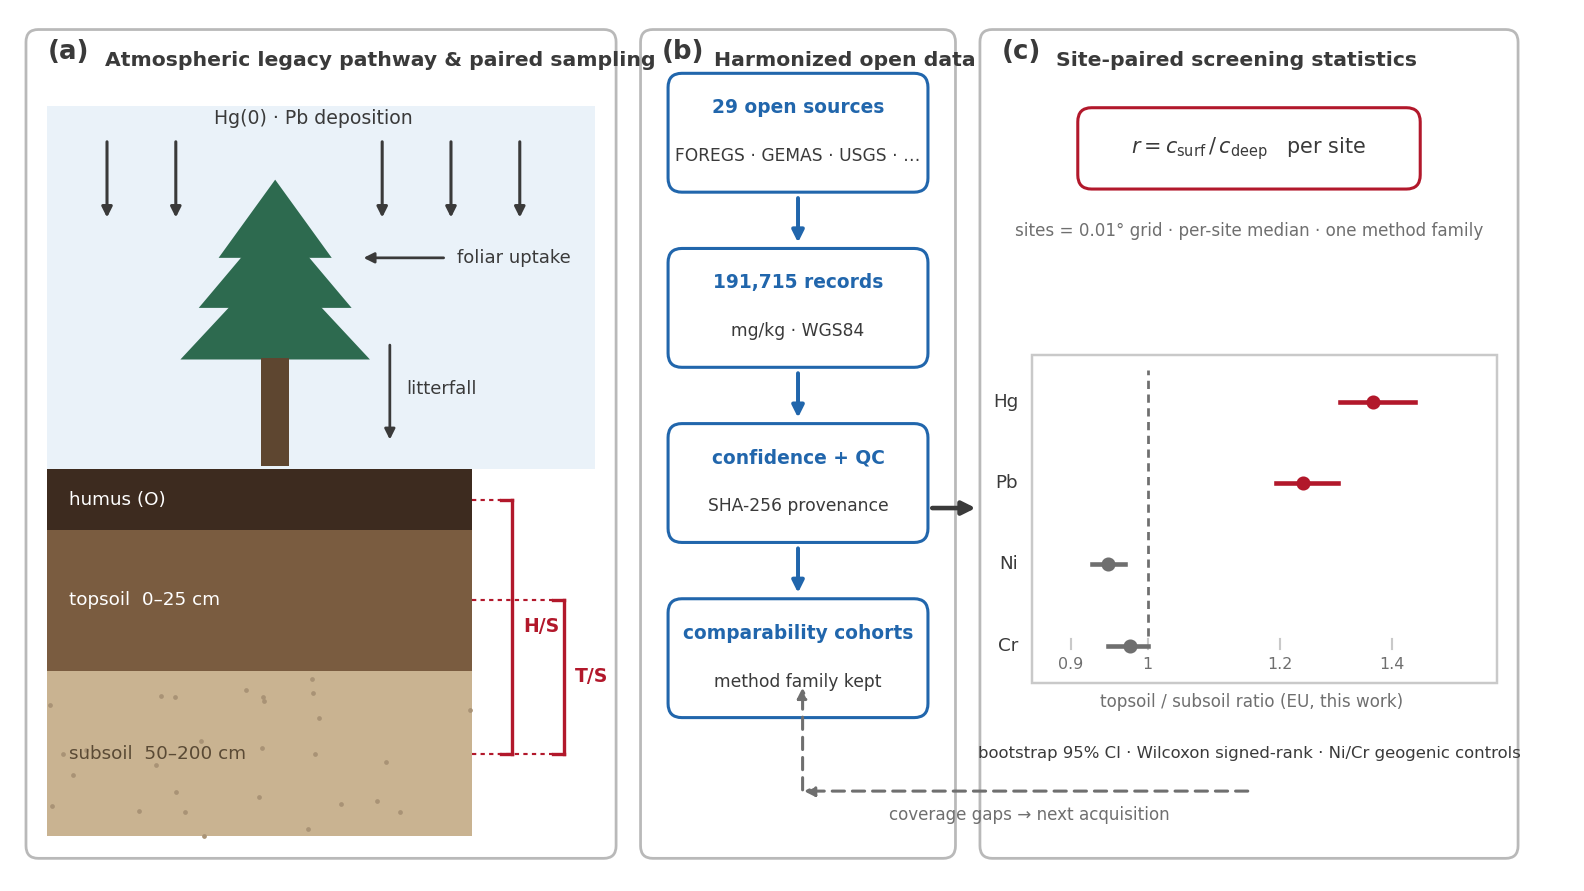
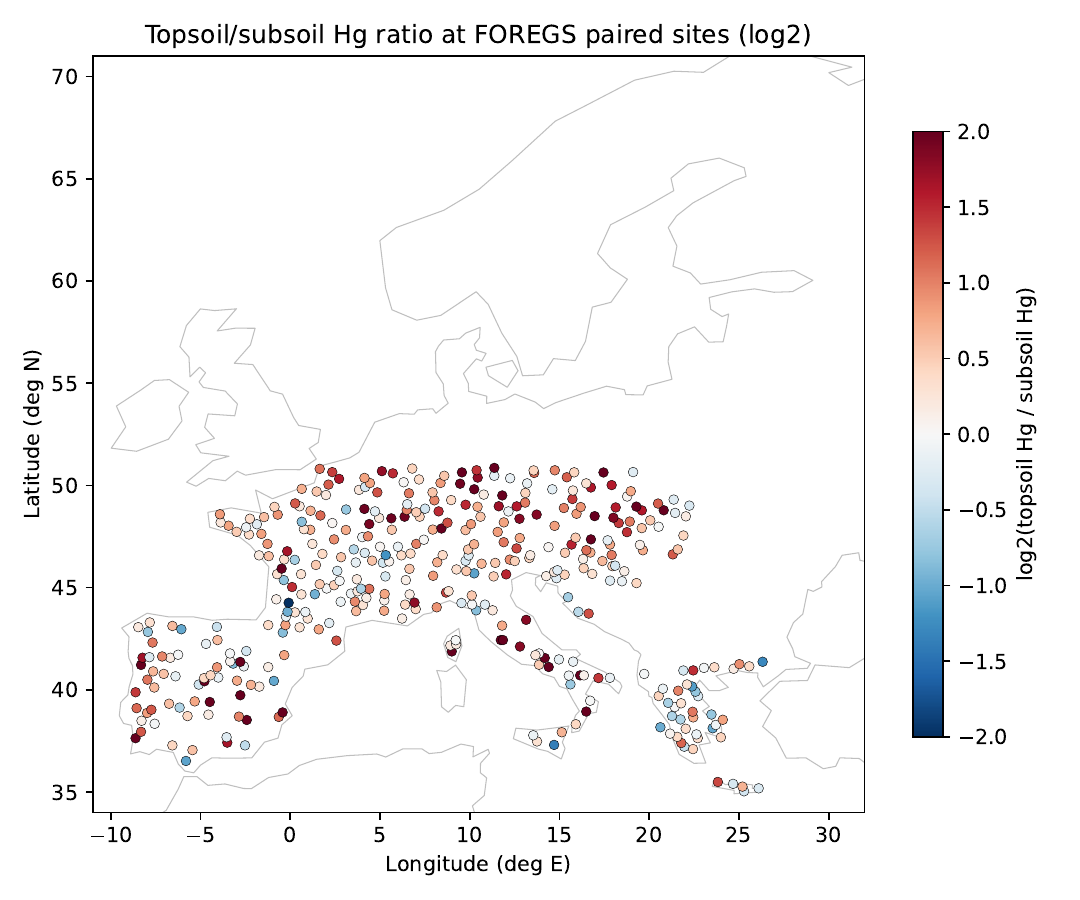
研究一 · 欧洲土壤中的汞铅遗留 工业时代遗留下来的汞和铅,今天是否仍积存在欧洲表层土壤中?
392 组对照显示,表层土壤的汞含量约为深层的 1.36 倍,腐殖质层的富集倍数达到 5.26;已形成 10 页论文初稿。
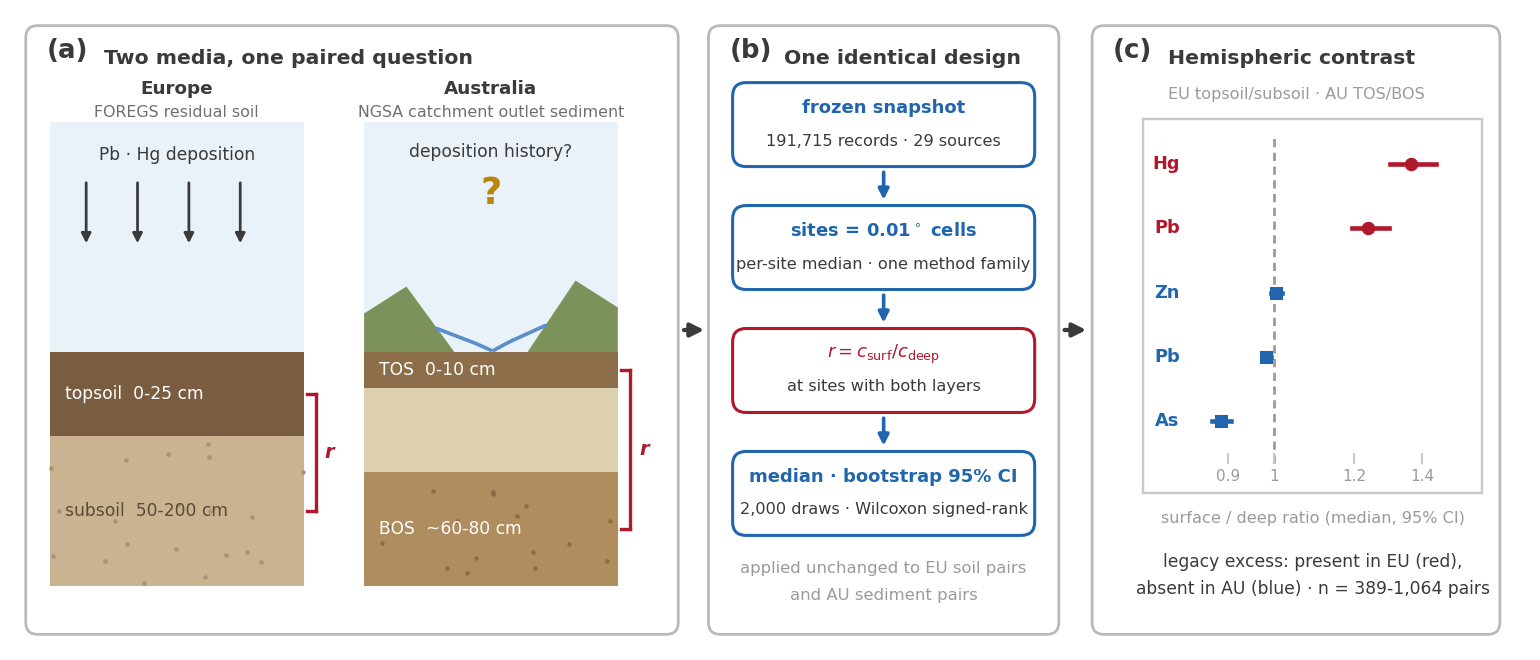
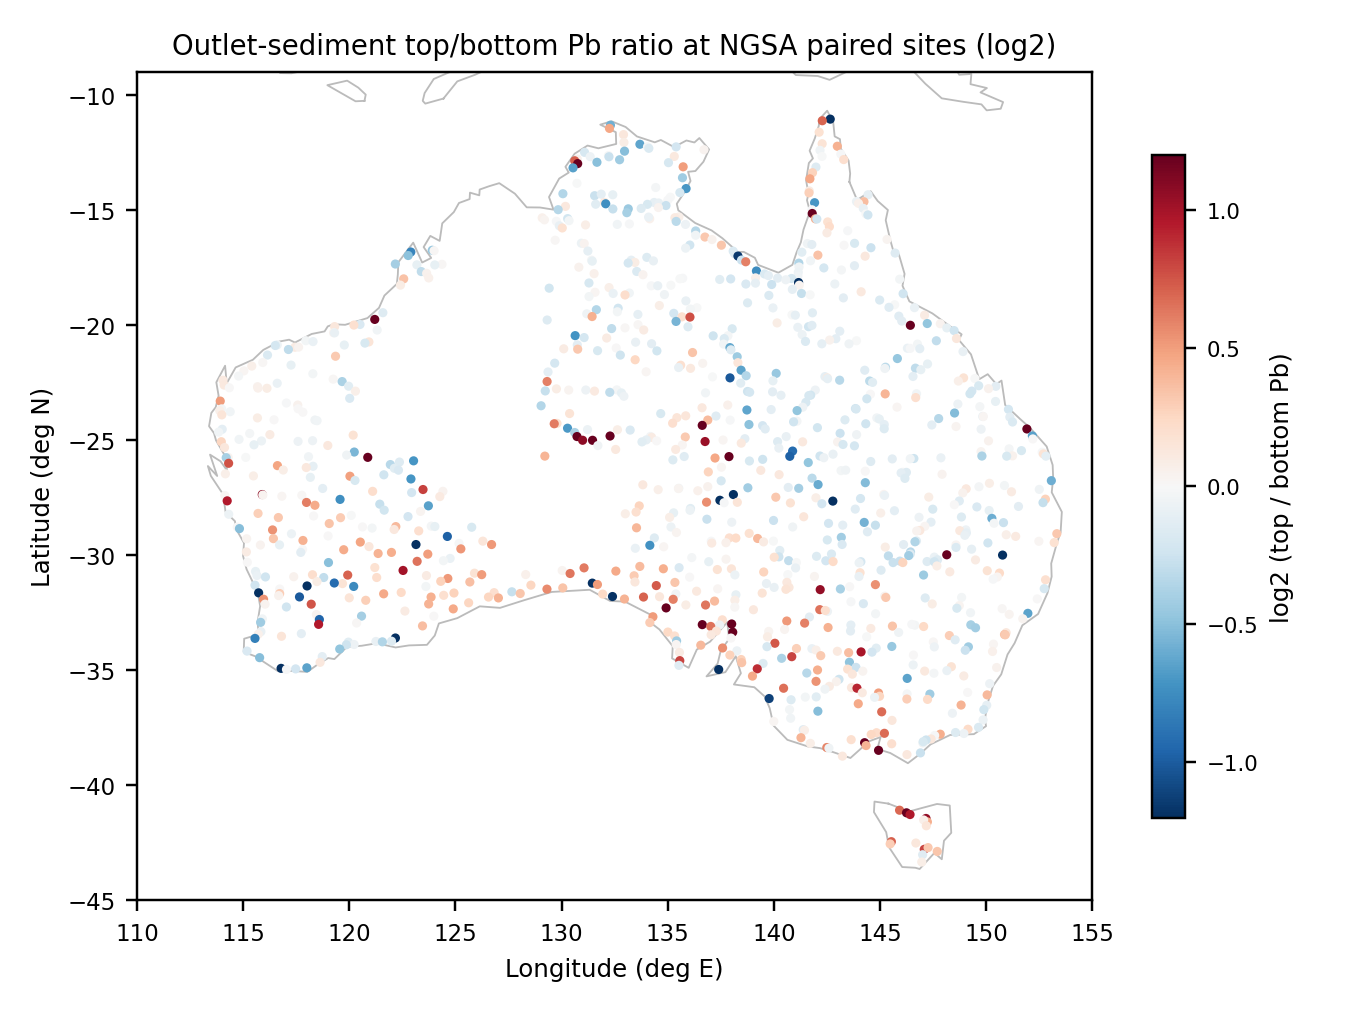
研究二 · 欧洲的铅富集在澳大利亚是否存在 欧洲表层土壤中明显的铅富集,在澳大利亚是否也存在?
澳大利亚表层与深层土壤的铅含量几乎相同(0.98 倍),欧洲表层则更高(1.24 倍),说明两地存在明显差异;已形成 9 页论文初稿。
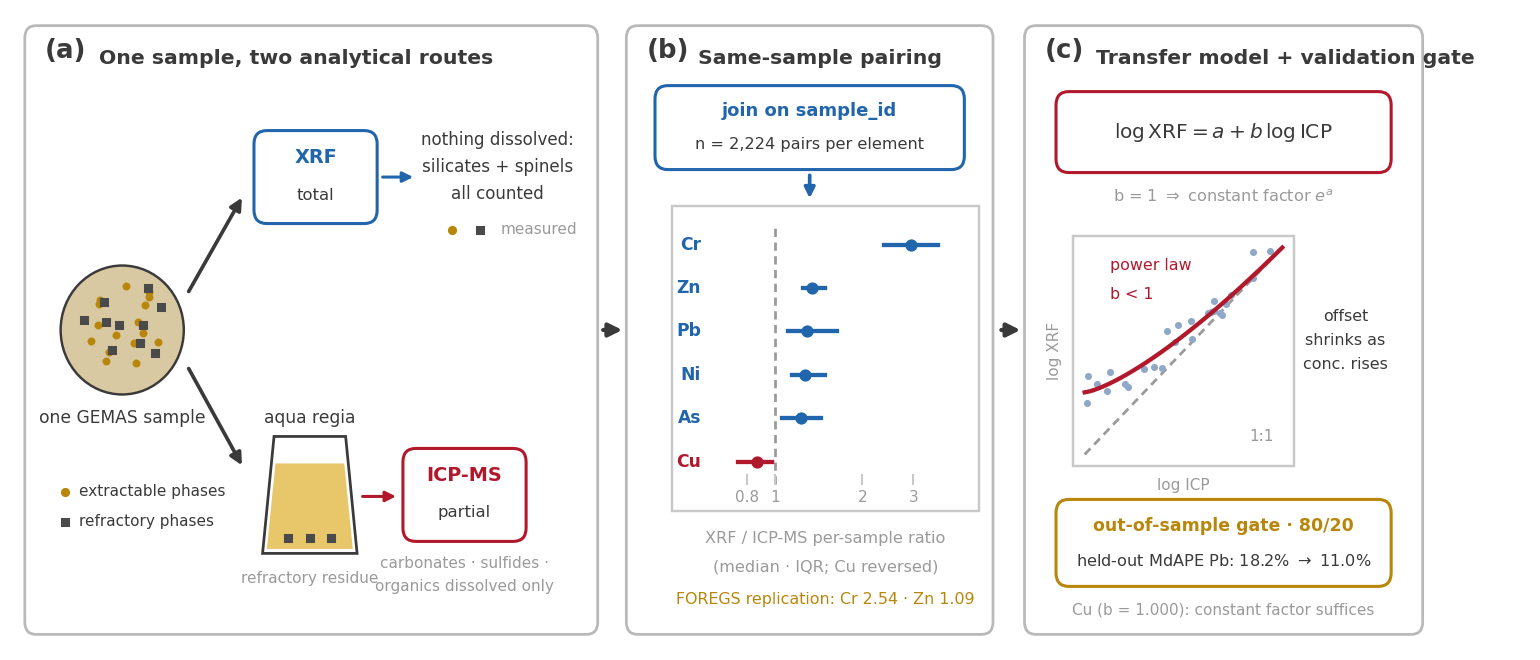
研究三 · 不同检测方法的数据能否直接合并 两种常用元素检测方法得到的结果,能不能直接放在一起分析?
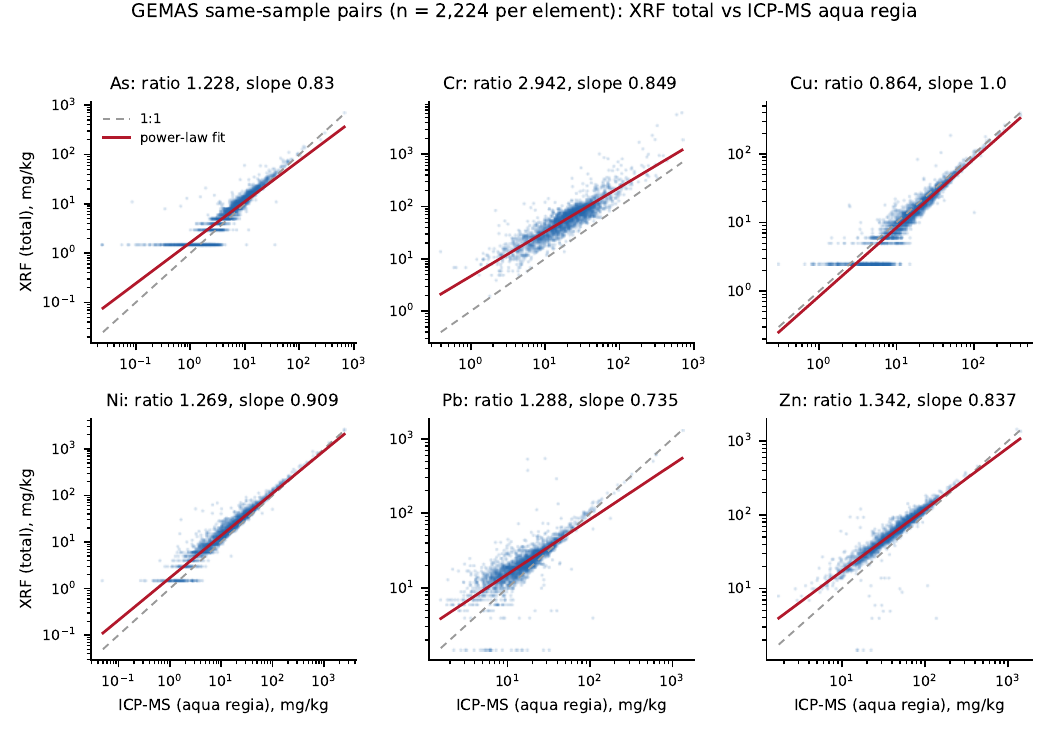
以铬为例,两种方法测得的结果相差约 2.94 倍,不能直接混用;经过校正,误差从 18.2% 降至 11.0%;已形成 9 页论文初稿。
研究四 · 全球砷风险图是否可靠 全球砷风险图与独立采集的实测数据是否一致?
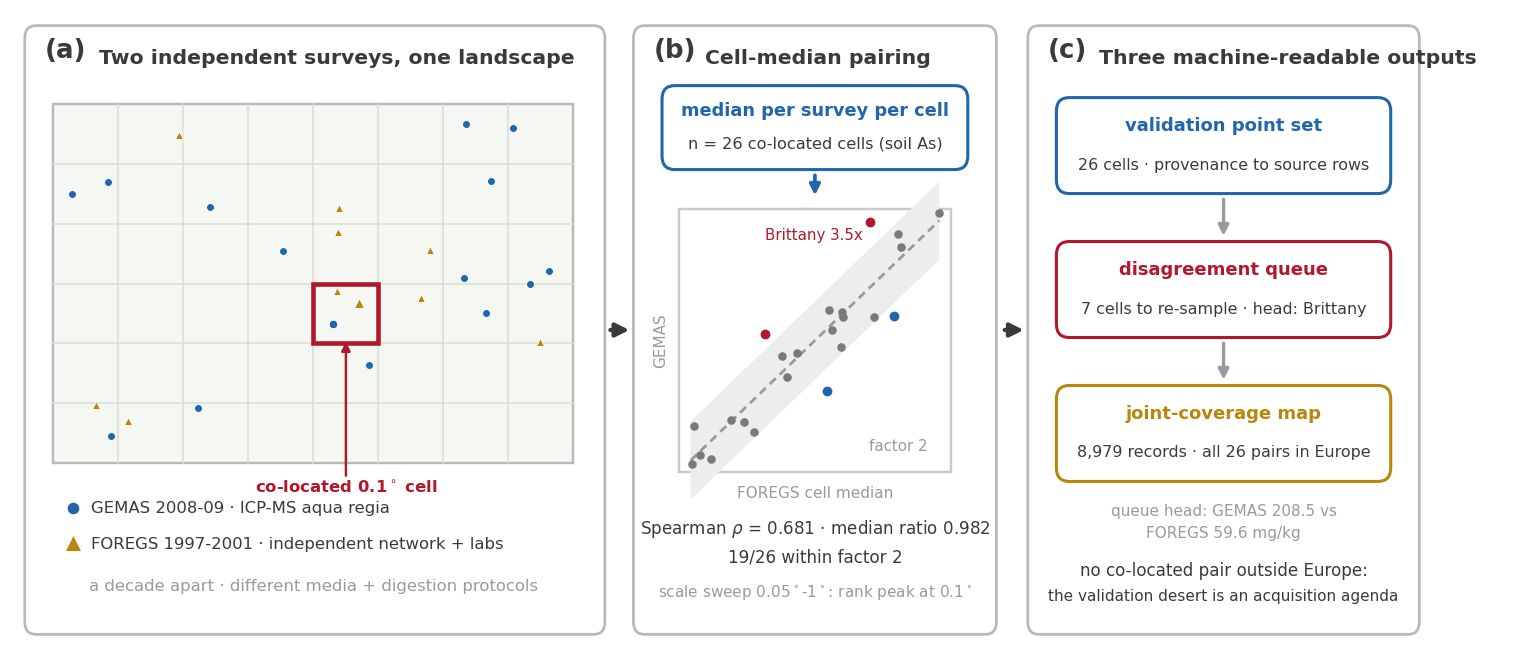
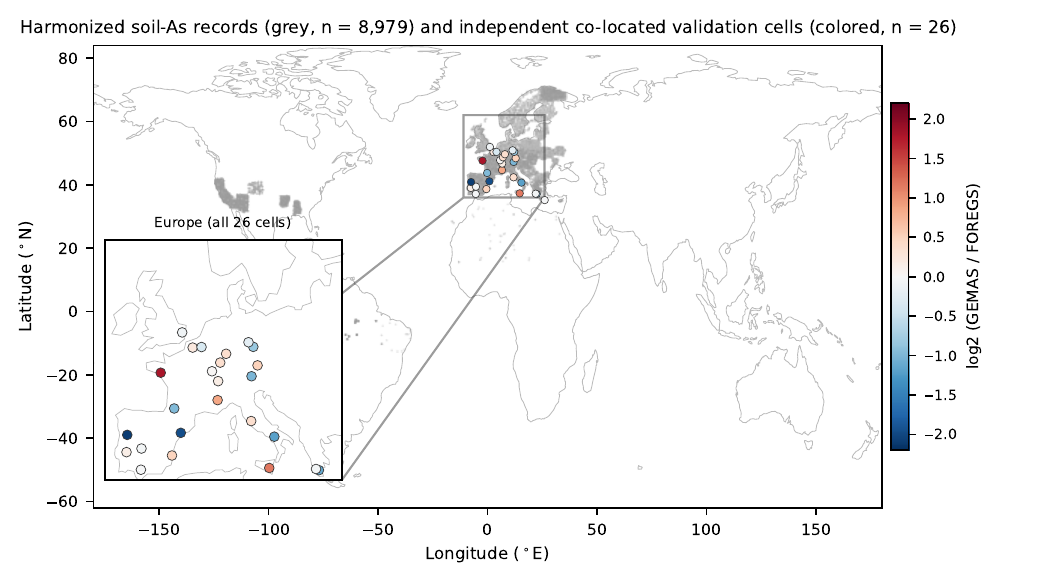
在 26 个相同地点进行对照后,两套数据的总体趋势较一致;其中 7 个差异较大的地点需要重新采样;已形成 9 页论文初稿。
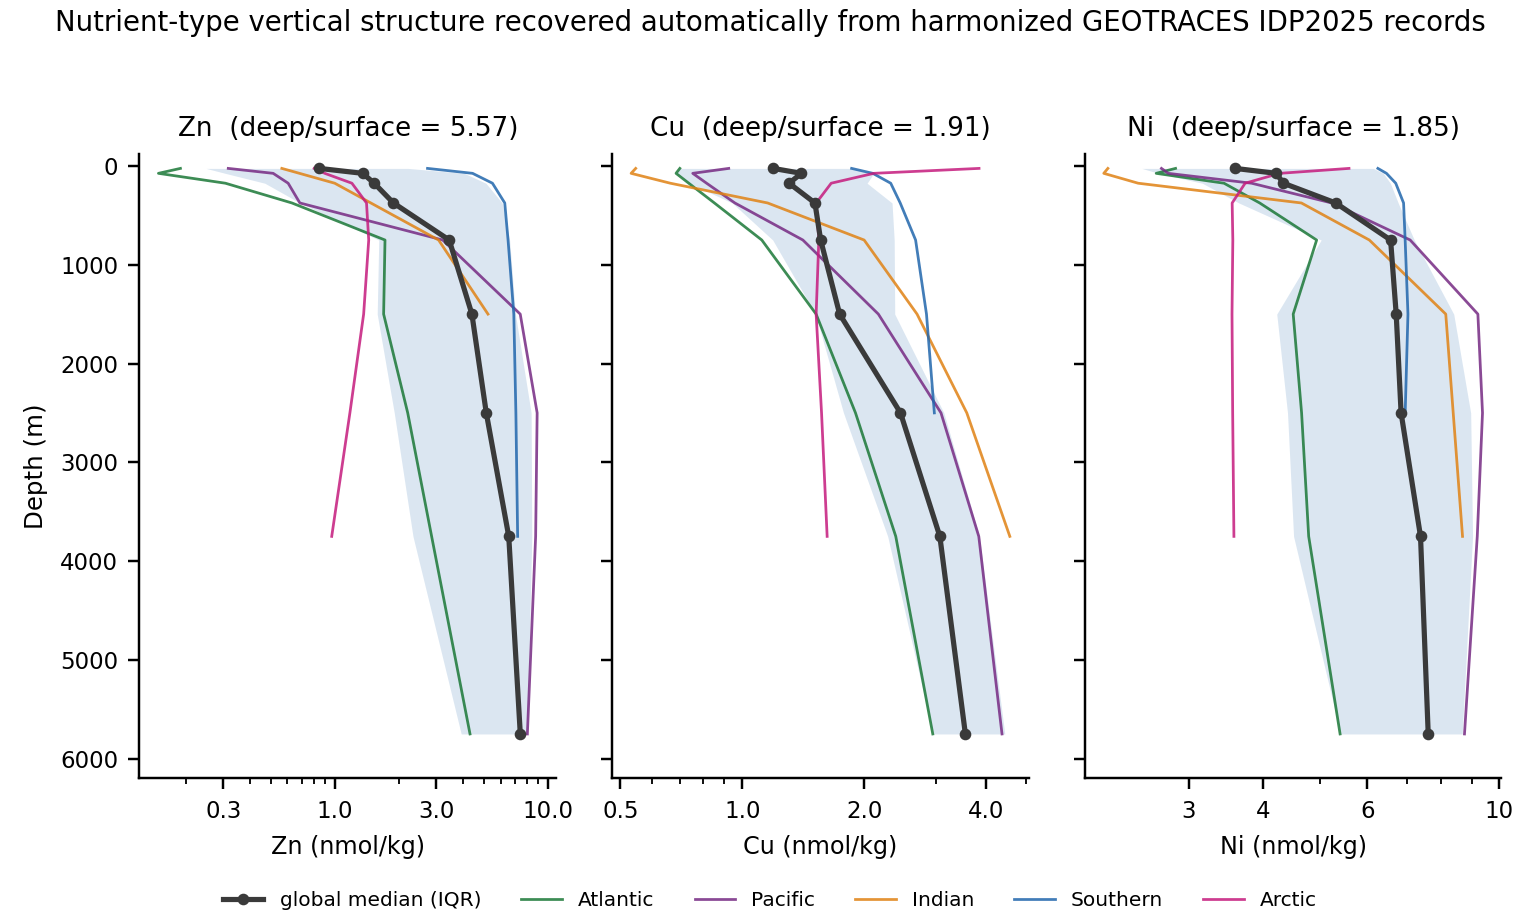
研究五 · 复核海洋微量金属的分布规律 重新分析国际海洋调查数据,能否得到相同的锌分布规律?
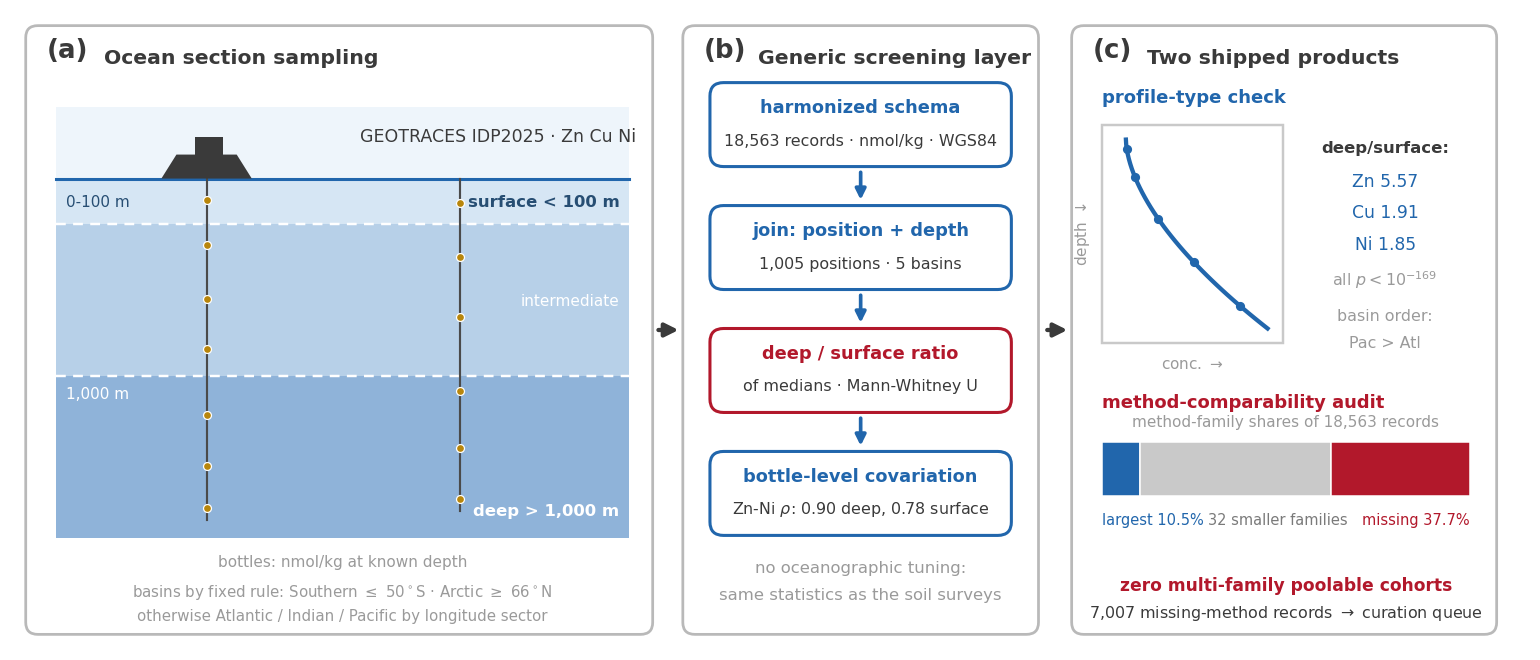
结果显示,深层海水中的锌含量约为表层的 5.57 倍,并再次观察到太平洋整体高于大西洋的规律;已形成 9 页论文初稿。
已完成 5 篇论文初稿,共 46 页、24 幅图和 9 张表 题目不是人拍脑袋定的,是从图谱现象里长出来的 论文暴露的数据缺口,会回到下一轮采样
可以把这条线想成一个不知疲倦的研究生。它先扫图谱,把异常现象变成 31 个可检验的问题;但不会一上来就写论文,而是先小规模试跑,免得整套分析花在站不住的题上。接着是防幻觉的硬门:已知结论复现不过,就不准讲新发现。通过后,选题、大纲、文献、分节写作、精修和绘图由不同角色接力。写稿的模型不审自己,换一类模型独立做 7 项检查;审稿意见和已验证事实写进研究记忆,下一轮接着改。现在已经形成 5 篇初稿、46 页、24 幅图和 9 张表——比如研究一发现工业时代的汞铅仍滞留在欧洲表土,研究三证明两种检测方法的数据不能直接混用。结论为筛查级,投稿前待领域专家复核。论文暴露的数据缺口再进入采集队列,于是数据、发现、论文又回到数据。
17 · POSITIONING / DATABASE LANDSCAPE
相比同类数据库,我们的优势在哪里
诚实前提:不与机构级规模竞争,补的是「统一层」空位
同类库要么大而不统一 (文献/档案汇编),要么统一而窄 (单介质或单大洲)
系统 规模 介质 统一单位 记录级许可 溯源哈希 方法元数据 置信度·QC 交叉验证 缺口队列 时序演化 数据→论文 GGA(本项目) 199,723 条 / 36 源 四介质一表 ✓ lineage ✓ 100% ✓ SHA-256 ✓ 缺失记账 ✓ 四维 100% ✓ 26 单元 ✓ 缺口→采集 ✓ 35.1% 带时间 ✓ 5 篇成稿 GEOROC / DIGIS 4,270 万值 / 70.7 万样品 火成岩·矿物 —(按发表值) 数据集级 —(文献级) ✓ 分析级 — — — — — EarthChem·PetDB ≈5,000 万值 / >100 万样品 固体地球联邦 —(原口径) 数据集级 IGSN 样品级 ✓ 分析级 — — — — — USGS NGDB 152 万样品 / 5,900 万测定 岩沉土矿(美) —(108 方法) 公共域 — 无统一层 — — — — — GEOTRACES IDP2025 123 航次 / 4,097 站 / 220 万值 仅海水 产品内统一 产品级 —(航次级) ✓ 值级 flag crossover — 时间列(不归因) — 大洲级调查×6 GEMAS 4,329 · FOREGS 900 · NGSA 1,315 · LUCAS 2.2万 · AfSIS 1.8万 · CGB 6,617 单介质/单大洲 调查内统一 数据集级 — 单一体系 调查级 QC — — — —
更全面 · 可扩展可定制同一 schema 覆盖土壤、沉积物、淡水与海水四种介质;新来源按声明式接入规范随时加入,元素、区域、介质均可按需定制。
更可靠 · 每条数据带完整证据链每条记录都有许可证、SHA-256 哈希、置信度与 QC 标记,可回溯到原始来源;36.3% 缺方法的记录逐条记明缺失原因——「缺什么」本身也是数据。
更统一 · 跨来源跨介质可比36 个来源统一到同一单位、坐标系和字段口径,不同调查的数据可以直接放在一起比较;同一脚本框架一晚跑完欧洲与澳洲两大洲。
最后回答一个定位问题:这个东西和 EarthChem、GEOROC、USGS 数据库有什么区别?诚实地说,论绝对规模我们不竞争——GEOROC 官网计数器四千二百七十万值、七十万样品,EarthChem 门户约五千万值、超一百万样品,USGS 数据库一百五十二万样品、五千九百万测定,都是几十年机构积累。但它们要么大而不统一:文献和档案汇编,一百零八种方法二十五个实验室并存,池化风险用户自负;要么统一而窄:GEOTRACES 最新 2025 数据产品一百二十三个航次、四千余站,但只有海水;GEMAS、FOREGS、NGSA、LUCAS 这些大洲级调查内部很统一,调查之间互不可比。跨源、跨介质、记录级可审计的统一层此前不存在——OneGeochemistry 发起人自己说,全球数据碎片化在数千个库里、几乎不可复用。这正是我们补上的空位:百分之百行级哈希、许可证、四维置信度,连缺失都逐条记账。表格最右两列是本轮新增的维度:带成因归因的时序演化、从数据直接长出的五篇论文——在同类系统里都没有对应物。所有外部数字都核验自官方页面,出处清单在仓库里。
18 · SHOWCASE / ALL DELIVERABLES AT A GLANCE
作品展示
这一页把全部作品放在一起:决赛海报一页总览方案与结果;演示仓库完全开源,幻灯片、四域图谱和五篇论文成果都在里面;项目主页汇总了赛题、效果展示、真实运行和全部材料下载;最右是两件实测产物——全球交互图谱和时序演化图谱,都可以现场点开操作。所有内容在线可访问,也打包了离线版本。
20 · THANK YOU / FIVE DELIVERABLES + TWO INNOVATIONS
感谢各位评委,请批评指正
1 可交互元素分布地图世界 · 中国 · 欧洲 · 美国全部交付
2 标准化地球化学数据库199,723 条 · 36 来源 · mg/kg · WGS84
3 数据来源与置信度说明四维证据诊断 · 记录级追溯
4 异常区域识别结果富集 / 亏损分开 · 判据卡片可复核
5 可复用 Skill 文档最终提交物 · 跨平台公共接口
+ 完整科研流程:图谱 → 发现 → 论文31 候选 → 5 篇成稿 · 46 页 · a–g 审计全过
+ 时序元素演化图谱回答“地质富集,还是工业活动”
决赛海报 实测图谱 官网主页 幻灯片 小红书 知乎
全球地球化学元素分布图谱面向 AI Agent 的可复用科研 Skill · GLOBAL GEOCHEMICAL ATLAS 词元代理人队 · 李雨峰 · 王培朔 · 郭欣睿 · 白丰硕 · 李明伟
最后总结。左边七项:赛题要求的五项交付——可交互地图、标准化数据库、来源与置信度、异常识别、可复用 Skill 文档——再加两项创新:从图谱到论文的完整科研流程,和回答“地质富集还是工业活动”的时序演化图谱。右边六个二维码:决赛海报、实测图谱、官网主页、本幻灯片、小红书和知乎专栏,欢迎评委现场扫码操作。我们是词元代理人队:李雨峰、王培朔、郭欣睿、白丰硕、李明伟。感谢各位评委,请批评指正。
 判据卡片实拍 · 比背景中位数高 23.3 倍 · 点击打开 ↗
 ✓ 交互图谱 + 3D
 ✓ 标准化数据库
 ✓ 异常识别结果
 李雨峰YUFENG LI上海交通大学 · 博士生师从严骏驰教授;研究方向为图机器学习、具身智能与最优传输理论
 王培朔PEISHUO WANG上海交通大学 · 博士生师从吴帆教授;研究方向为视觉-语言-动作(VLA)模型与化学实验室自动化
 郭欣睿XINRUI GUO北京航空航天大学 · 人工智能博士生香港理工大学机械工程硕士;金属材料专业学士,材料与人工智能交叉背景
 白丰硕FENGSHUO BAI上海交通大学 · 计算机系博士生师从杨耀东、温颖两位教授(联合指导);PAIR-Lab 实验室成员
 李明伟MINGWEI LI浙江大学 · 博士生研究方向为三维(3D)与四维(4D)场景重建及生成式模型
 决赛海报
 实测图谱
 官网主页
 幻灯片
 小红书
 知乎